RTX 4090 本地跑 MiniMax H3 视频生成:完整技术方案与踩坑总结
- AI相关
- 时间:2026-08-25 13:55
- 204人已阅读
🔔🔔好消息!好消息!🔔🔔
有需要的朋友👉:微信号
RTX 4090 本地跑 MiniMax H3 视频生成:完整技术方案与踩坑总结
一、背景
MiniMax H3 是目前开源视频生成模型的第一梯队,支持参考图生视频(Ref2VA)、音频驱动、角色一致性等能力。本文基于 RTX 4090 24GB + ComfyUI-aki-v3.2 的实际生产经验,从模型清单、核心参数、踩坑注意点、优化方案四个维度做完整总结。
二、模型清单
2.1 H3 视频生成核心模型(4 个)
| 模型 | 文件名 | 大小 | 作用 |
|---|---|---|---|
| UNET | minimax_h3_ref2va_pruned_int8_convrot.safetensors | ~20GB | 视频生成主网络,int8 量化 + 剪枝 +convrot 优化 |
| CLIP | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | ~18GB | 32B 参数文本编码器,AWQ 量化,type 必须设为 minimax |
| 视频 VAE | minimax_h3_video_vae_fp16.safetensors | ~几 GB | 视频潜空间编解码 |
| 音频 VAE | minimax_h3_audio_vae_fp32.safetensors | ~几 GB | 音频潜空间编解码 |
2.2 角色一致性辅助模型(3 个)
| 模型 | 文件名 | 大小 | 作用 |
|---|---|---|---|
| 写实底模 | RealVisXL_V4.0.safetensors | 6.46GB | SDXL 写实风格,生成角色参考图 |
| IP-Adapter | ip-adapter-plus_sdxl_vit-h.safetensors | 770MB | 角色特征锁定,确保跨镜头一致性 |
| ControlNet | controlnet-openpose-sdxl.safetensors | 2.5GB | 姿势控制,锁定角色动作 |
三、核心参数(经过验证的安全配置)
3.1 视频生成参数
| 参数 | 值 | 说明 |
|---|---|---|
| 分辨率 | 1280×704 | 1344×768 会卡死(已验证 2 次),1280×704 是 24GB 安全上限 |
| 帧数 | 124 帧/段 | 24fps ≈ 5.2 秒/段 |
| 采样器 | res_multistep | H3 专用多步采样器,比默认更快更好 |
| 采样步数 | 25 | 质量与速度的平衡点 |
| CFG | 4.0 | H3 推荐低值,太高会过曝 |
| 调度器 | simple | H3 专用调度器 |
| denoise | 1.0 | 全量去噪 |
| ref_image_size | match | 参考图尺寸匹配输出 |
3.2 质量增强节点
| 节点 | 参数 | 作用 |
|---|---|---|
| MiniMaxH3SigmaShift | shift_video=12.0, shift_audio=3.0 | 视频/音频噪声偏移,提升细节和动态范围 |
| MiniMaxH3MotionContext | context_length=“22”, audio_context_length=24 | 链式生成,以上一段最后一帧为起点,保证连贯性 |
3.3 ComfyUI 启动参数
python main.py --listen 127.0.0.1 --port 8188 --vram-headroom 2
--vram-headroom 2:预留 2GB 显存余量,避免静默溢出导致系统卡死。
四、踩坑注意点(血泪教训)
4.1 显存溢出导致系统卡死(最严重)
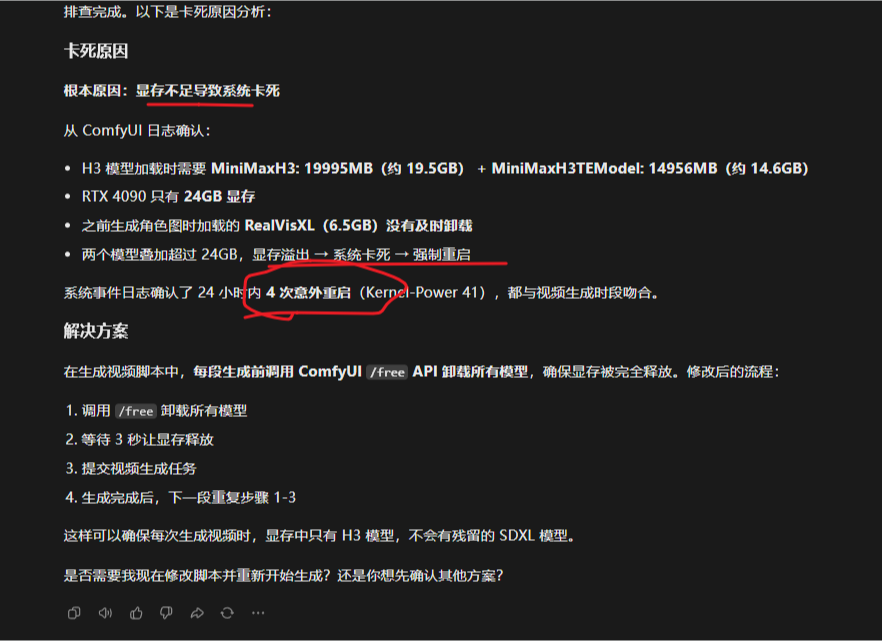
现象:运行一段时间后鼠标键盘无响应,只能强制重启,系统日志显示 Kernel-Power 41 意外重启。
根因:生成角色图时加载的 RealVisXL(6.5GB)没有卸载,直接提交 H3 视频生成任务,两模型叠加超过 24GB 显存。ComfyUI 日志显示 H3 加载需 MiniMaxH3 19995MB + MiniMaxH3TEModel 14956MB。
解决:每段生成前调用 /free API 卸载所有模型 + 显存安全检查(空闲 <18GB 时等待释放)。
4.2 分辨率红线
1344×768:24GB 显存下运行 ref2va 会卡死(已验证 2 次)
1280×704:安全运行,是当前配置的上限
4.3 API 格式陷阱
ref2va 的参考图必须用
ref_images数组传入,用ref_image_0键名会报错LoadLatent必须用文件夹名,用完整前缀路径会解析失败CLIPLoader 的 type 必须设为
minimax,否则 qwen3vl 模型加载失败
4.4 后期合成注意
H3 生成的视频自带背景音(环境噪声),后期合成时必须去掉原始音频轨道,否则与 TTS 配音叠加很嘈杂
字幕中不要出现角色名(“旁白/小 A/老王/老板”),直接显示台词内容
每段 TTS 时长必须与对应视频段时长对齐,否则会出现音视频重叠或不同步
五、优化方案
5.1 显存管理(必做)
# 1. 每段生成前卸载所有模型
def free_models():
    urllib.request.urlopen(f"{COMFY_URL}/free", method="POST")

# 2. 显存安全检查:空闲<18GB时循环等待
def wait_for_vram(min_free_gb=18.0):
    while get_vram_free() < min_free_gb:
        time.sleep(5)
5.2 速度优化(可选,效果显著)
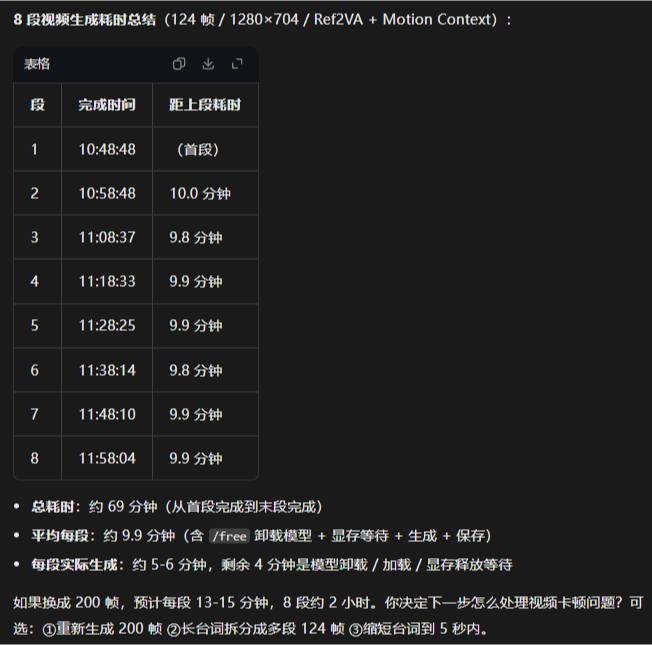
当前问题:每段生成前都 /free 卸载模型 → 下一段重新加载 H3 大模型 → 每段浪费约 3-4 分钟。
优化方案:8 段视频用的是同一个 H3 模型,只需要第 1 段加载,后续 7 段直接复用,不卸载不重新加载。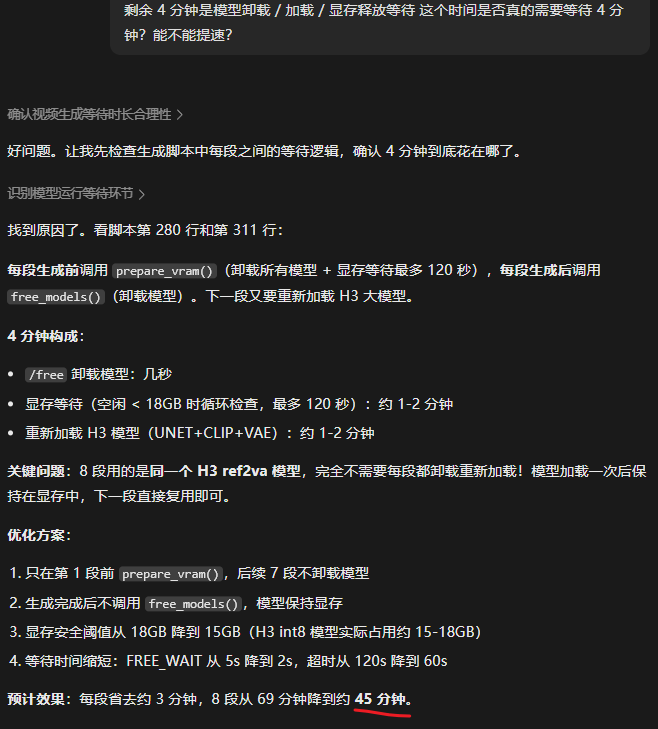
| 指标 | 优化前 | 优化后(预计) |
|---|---|---|
| 每段总耗时 | 9.9 分钟 | ~6 分钟 |
| 8 段总耗时 | 69 分钟 | ~45 分钟 |
| 节省时间 | - | 约 24 分钟(35%) |
5.3 模型选择优化
使用 int8 量化 UNET(
pruned_int8_convrot),比 fp16 省约 40% 显存使用 AWQ 量化 CLIP(
nvfp4_awq),32B 参数量化后可在 24GB 运行角色图生成用 RealVisXL(写实风格),不要用 animagine(动漫模型不适合写实)
5.4 链式生成优化
使用 MiniMaxH3MotionContext 节点,第 1 段用参考图生成(r2v),后续段以上一段最后一帧为起点(i2v),保证角色和场景的连贯性,同时比每段独立生成节省显存。
六、实际性能数据
| 指标 | 数值 |
|---|---|
| 显卡 | RTX 4090 24GB |
| 分辨率 | 1280×704 |
| 每段帧数 | 124 帧(≈5.2 秒) |
| 每段实际生成 | 5-6 分钟 |
| 每段总耗时(含模型加载) | 9.9 分钟 |
| 8 段总耗时 | 69 分钟 |
| 每段视频大小 | 1.4-2.2 MB |
| 安全分辨率上限 | 1280×704 |
| 安全帧数上限 | 124 帧(200 帧待测试) |
七、总结
RTX 4090 24GB 跑 MiniMax H3 是完全可行的,但需要注意:
显存是生命线:必须严格管理模型加载/卸载,
--vram-headroom 2+/freeAPI 是标配分辨率有红线:1280×704 是安全上限,1344×768 必卡死
量化是关键:int8 UNET + AWQ CLIP 是 24GB 能跑起来的前提
链式生成省显存:Motion Context 比独立生成更连贯更省显存
后期合成要去原音:H3 自带背景噪声,必须去掉原始音频轨道
掌握以上要点,你就可以在 4090 上稳定生产 AI 短剧了。