消息系统kafka之二 kafka的HA(高可用)
在前面的《消息系统kafka之一 系统简介》的为什么选择kafka中已经提到了kafka高可用的特性。
下面是kafka与其他消息系统之间的区别
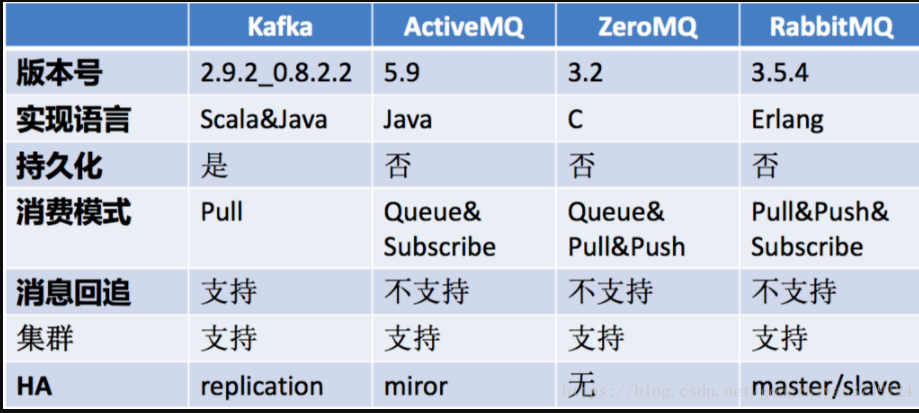
可以看出,kafka支持持久化消息,消息回追等功能,在HA方面kafka使用的是replication策略
在了解replication机制之前必须看下kafka的系统架构的文件存储机制
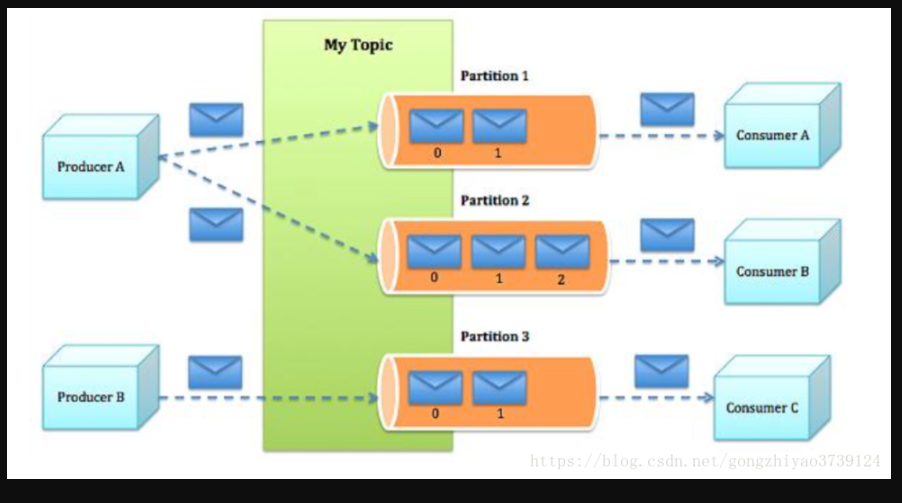
如图,kafka中的消息是以topic进行分类的,生产者通过topic向kafka broker发送消息,消费者通过topic读取消息。然而topic在物理层面上又能够以partition进行分组,在上一篇已经提到,一个topic可以分为多个partition,那么topic以及partition是怎么存储的呢?partition还可以细分为segment,一个物理上有多个segment组成,那么这些segment又是什么呢?
为了便于说明问题,假设这里只有一个Kafka集群,且这个集群只有一个Kafka broker,即只有一台物理机。在这个Kafka broker中配置($KAFKA_HOME/config/server.properties中)log.dirs=/tmp/kafka-logs,以此来设置Kafka消息文件存储目录,与此同时创建一个topic:topic_vms_test,partition的数量为4($KAFKA_HOME/bin/kafka-topics.sh --create --zookeeper localhost:2181 --partitions 4 --topic topic_vms_test --replication-factor 4)。那么我们此时可以在/tmp/kafka-logs目录中可以看到生成了4个目录
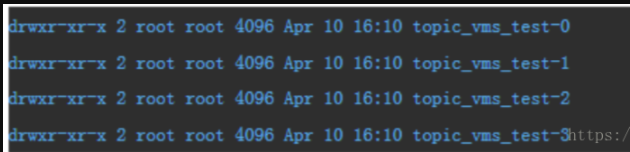
在Kafka文件存储中,同一个topic下有多个不同的partition,每个partiton为一个目录,partition的名称规则为:topi
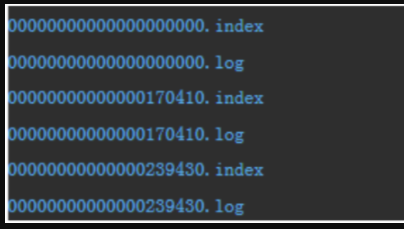
“.index”索引文件存储大量的元数据,“.log”数据文件存储大量的消息,索引文件中的元数据指向对应数据文件中message的物理偏移地址。其中以“.index”索引文件中的元数据[3, 348]为例,在“.log”数据文件表示第3个消息,即在全局partition中表示170410+3=170413个消息,该消息的物理偏移地址为348。
如 00000000000000000170410.index 和 log 文件的对应如下
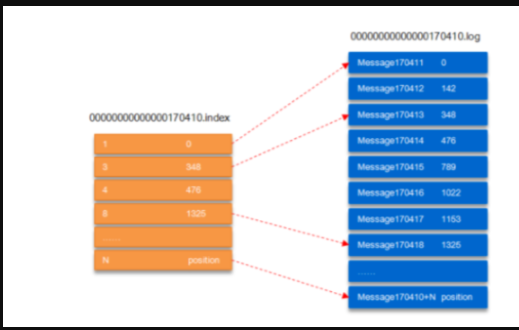
那么如何从partition中通过offset查找message呢?以上图为例,读取offset=170418的消息,首先查找segment文件,其中 00000000000000000000.index为最开始的文件,第二个文件为00000000000000170410.index(起始偏移为170410+1=170411),而第 三个文件为00000000000000239430.index(起始偏移为239430+1=239431),所以这个offset=170418就落到了第二个文件之中。其他 后续文件可以依次类推,以其实偏移量命名并排列这些文件,然后根据二分查找法就可以快速定位到具体文件位置。其次根据 00000000000000170410.index文件中的[8,1325]定位到00000000000000170410.log文件中的1325的位置进行读取。
要是读取offset=170418的消息,从00000000000000170410.log文件中的1325的位置进行读取,那么怎么知道何时读完本条消息,否则 就读到下一条消息的内容了?这个就需要联系到消息的物理结构了,消息都具有固定的物理结构,包括:offset(8 Bytes)、消息体的大 小(4 Bytes)、crc32(4 Bytes)、magic(1 Byte)、attributes(1 Byte)、key length(4 Bytes)、key(K Bytes)、payload(N Bytes)等等字段,可以确定一条消息的大小,即读取到哪里截止。
kafka的高可用就是依赖于上面的文件存储结构的,kafka能保证HA的策略有 data replication和leader election。
Kafka中topic的每个partition有一个预写式的日志文件,虽然partition可以继续细分为若干个segment文件,但是对于上层应用来说可以将 partition看成最小的存储单元(一个有多个segment文件拼接的“巨型”文件),每个partition都由一些列有序的、不可变的消息组成,这些消息被连续的追加到partition中。
在kafka0.8版本之后 ,为了提高消息的可靠性,Kafka每个topic的partition有N个副本(replicas),其中N(大于等于1)是topic的复制因子(replica fator)的个数。这个时候每个 partition下面就有可能有多个 replica(replication机制,相当于是partition的副本但是有可能存储在其他的broker上),但是这多个replica并不一定分布在一个broker上,而这时候为了更好的在replica之间复制数据,此时会选出一个leader,这个时候 producer会push消息到这个leader(leader机制),consumer也会从这个leader pull 消息,其他的 replica只是作为follower从leader复制数据,leader负责所有的读写;如果没有一个leader的话,所有的replica都去进行读写 那么NxN(N+1个replica之间复制消息)的互相同步数据就变得很复杂而且数据的一致性和有序性不能够保证。
为了实现更高的可用性,推荐在部署kafka的时候,能够保证一个topic的partition数量大于broker的数量,而且还需要把replica均匀的分布在所有的broker上,不能够只分布在一个 broker上,如果只分布在一个broker上,此时如果broker 宕机,会导致所有的replica都不能够提供服务,partition数据丢失或是不能够写入和读取,所以需要均匀的分布replica,即使某个broker宕机,但是可以保证它上面的负载可以被均匀的分配到其他幸存的拥有replica的broker上。
kafka 分配replica的算法是:
1.将所有的broker(假设共有n个broker) 和 partition进行排序
2.将第i个partition分配到第(i mod n)个broker上
3.将第i个partition的第j个replica分配到第((i+j)mod n)个broker上
zookeepe会对partition的l
原创不易,完成人机校验,阅读全文