【转摘】Kafka学习之路 (三)Kafka的高可用
目录
一、高可用的由来
1.1 为何需要Replication
1.2 Leader Election
二、Kafka HA设计解析
2.1 如何将所有Replica均匀分布到整个集群
2.2 Data Replication(副本策略)
三、HA相关ZooKeeper结构
3.1 admin
3.2 broker
3.3 controller
四、producer发布消息
4.1 写入方式
4.2 消息路由
4.3 写入流程
五、broker保存消息
5.1 存储方式
5.2 存储策略
六、Topic的创建和删除
6.1 创建topic
6.2 删除topic
七、broker failover
八、controller failover
正文
一、高可用的由来
1.1 为何需要Replication
在Kafka在0.8以前的版本中,是没有Replication的,一旦某一个Broker宕机,则其上所有的Partition数据都不可被消费,这与Kafka数据持久性及Delivery Guarantee的设计目标相悖。同时Producer都不能再将数据存于这些Partition中。
如果Producer使用同步模式则Producer会在尝试重新发送message.send.max.retries(默认值为3)次后抛出Exception,用户可以选择停止发送后续数据也可选择继续选择发送。而前者会造成数据的阻塞,后者会造成本应发往该Broker的数据的丢失。
如果Producer使用异步模式,则Producer会尝试重新发送message.send.max.retries(默认值为3)次后记录该异常并继续发送后续数据,这会造成数据丢失并且用户只能通过日志发现该问题。同时,Kafka的Producer并未对异步模式提供callback接口。
由此可见,在没有Replication的情况下,一旦某机器宕机或者某个Broker停止工作则会造成整个系统的可用性降低。随着集群规模的增加,整个集群中出现该类异常的几率大大增加,因此对于生产系统而言Replication机制的引入非常重要。
1.2 Leader Election
引入Replication之后,同一个Partition可能会有多个Replica,而这时需要在这些Replication之间选出一个Leader,Producer和Consumer只与这个Leader交互,其它Replica作为Follower从Leader中复制数据。
因为需要保证同一个Partition的多个Replica之间的数据一致性(其中一个宕机后其它Replica必须要能继续服务并且即不能造成数据重复也不能造成数据丢失)。如果没有一个Leader,所有Replica都可同时读/写数据,那就需要保证多个Replica之间互相(N×N条通路)同步数据,数据的一致性和有序性非常难保证,大大增加了Replication实现的复杂性,同时也增加了出现异常的几率。而引入Leader后,只有Leader负责数据读写,Follower只向Leader顺序Fetch数据(N条通路),系统更加简单且高效。
二、Kafka HA设计解析
2.1 如何将所有Replica均匀分布到整个集群
为了更好的做负载均衡,Kafka尽量将所有的Partition均匀分配到整个集群上。一个典型的部署方式是一个Topic的Partition数量大于Broker的数量。同时为了提高Kafka的容错能力,也需要将同一个Partition的Replica尽量分散到不同的机器。实际上,如果所有的Replica都在同一个Broker上,那一旦该Broker宕机,该Partition的所有Replica都无法工作,也就达不到HA的效果。同时,如果某个Broker宕机了,需要保证它上面的负载可以被均匀的分配到其它幸存的所有Broker上。
Kafka分配Replica的算法如下:
1.将所有Broker(假设共n个Broker)和待分配的Partition排序
2.将第i个Partition分配到第(i mod n)个Broker上
3.将第i个Partition的第j个Replica分配到第((i + j) mode n)个Broker上
2.2 Data Replication(副本策略)
Kafka的高可靠性的保障来源于其健壮的副本(replication)策略。
2.2.1 消息传递同步策略
Producer在发布消息到某个Partition时,先通过ZooKeeper找到该Partition的Leader,然后无论该Topic的Replication Factor为多少,Producer只将该消息发送到该Partition的Leader。Leader会将该消息写入其本地Log。每个Follower都从Leader pull数据。这种方式上,Follower存储的数据顺序与Leader保持一致。Follower在收到该消息并写入其Log后,向Leader发送ACK。一旦Leader收到了ISR中的所有Replica的ACK,该消息就被认为已经commit了,Leader将增加HW并且向Producer发送ACK。
为了提高性能,每个Follower在接收到数据后就立马向Leader发送ACK,而非等到数据写入Log中。因此,对于已经commit的消息,Kafka只能保证它被存于多个Replica的内存中,而不能保证它们被持久化到磁盘中,也就不能完全保证异常发生后该条消息一定能被Consumer消费。
Consumer读消息也是从Leader读取,只有被commit过的消息才会暴露给Consumer。
Kafka Replication的数据流如下图所示:
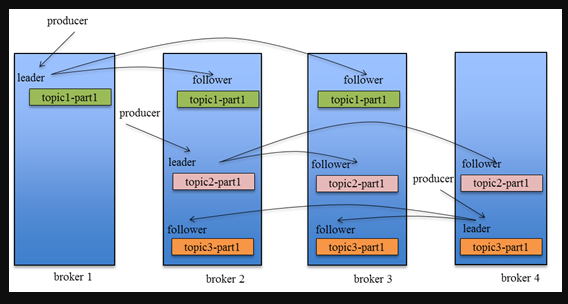
2.2.2 ACK前需要保证有多少个备份
对于Kafka而言,定义一个Broker是否“活着”包含两个条件:
一是它必须维护与ZooKeeper的session(这个通过ZooKeeper的Heartbeat机制来实现)。
二是Follower必须能够及时将Leader的消息复制过来,不能“落后太多”。
Leader会跟踪与其保持同步的Replica列表,该列表称为ISR(即in-sync Replica)。如果一个Follower宕机,或者落后太多,Leader将把它从ISR中移除。这里所描述的“落后太多”指Follower复制的消息落后于Leader后的条数超过预定值(该值可在$KAFKA_HOME/config/server.properties中通过replica.lag.max.messages配置,其默认值是4000)或者Follower超过一定时间(该值可在$KAFKA_HOME/config/server.properties中通过replica.lag.time.max.ms来配置,其默认值是10000)未向Leader发送fetch请求。
Kafka的复制机制既不是完全的同步复制,也不是单纯的异步复制。事实上,完全同步复制要求所有能工作的Follower都复制完,这条消息
原创不易,完成人机校验,阅读全文