【转摘】Kafka学习之路 (一)Kafka的简介
目录
一、简介
1.1 概述
1.2 消息系统介绍
1.3 点对点消息传递模式
1.4 发布-订阅消息传递模式
二、Kafka的优点
2.1 解耦
2.2 冗余(副本)
2.3 扩展性
2.4 灵活性&峰值处理能力
2.5 可恢复性
2.6 顺序保证
2.7 缓冲
2.8 异步通信
三、常用Message Queue对比
3.1 RabbitMQ
3.2 Redis
3.3 ZeroMQ
3.4 ActiveMQ
3.5 Kafka/Jafka
四、Kafka中的术语解释
4.1 概述
4.2 broker
4.3 Topic
4.3 Partition
4.4 Producer
4.5 Consumer
4.6 Consumer Group
4.7 Leader
4.8 Follower
正文
一、简介
1.1 概述
Kafka是最初由Linkedin公司开发,是一个分布式、分区的、多副本的、多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx日志、访问日志,消息服务等等,Linkedin于2010年贡献给了Apache基金会并成为顶级开源项目。
主要应用场景是:日志收集系统和消息系统。
Kafka主要设计目标如下:
以时间复杂度为O(1)的方式提供消息持久化能力,即使对TB级以上数据也能保证常数时间的访问性能。
高吞吐率。即使在非常廉价的商用机器上也能做到单机支持每秒100K条消息的传输。
支持Kafka Server间的消息分区,及分布式消费,同时保证每个partition内的消息顺序传输。
同时支持离线数据处理和实时数据处理。
Scale out:支持在线水平扩展
1.2 消息系统介绍
一个消息系统负责将数据从一个应用传递到另外一个应用,应用只需关注于数据,无需关注数据在两个或多个应用间是如何传递的。分布式消息传递基于可靠的消息队列,在客户端应用和消息系统之间异步传递消息。有两种主要的消息传递模式:点对点传递模式、发布-订阅模式。大部分的消息系统选用发布-订阅模式。Kafka就是一种发布-订阅模式。
1.3 点对点消息传递模式
在点对点消息系统中,消息持久化到一个队列中。此时,将有一个或多个消费者消费队列中的数据。但是一条消息只能被消费一次。当一个消费者消费了队列中的某条数据之后,该条数据则从消息队列中删除。该模式即使有多个消费者同时消费数据,也能保证数据处理的顺序。这种架构描述示意图如下:
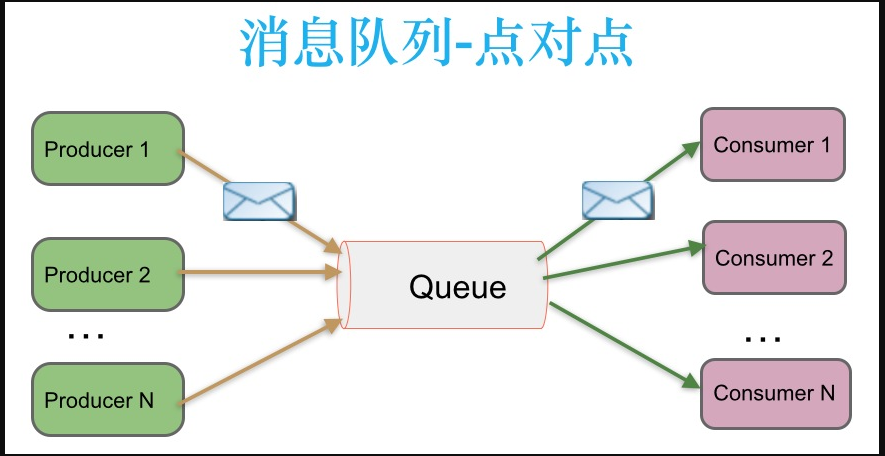
生产者发送一条消息到queue,只有一个消费者能收到。
1.4 发布-订阅消息传递模式
在发布-订阅消息系统中,消息被持久化到一个topic中。与点对点消息系统不同的是,消费者可以订阅一个或多个topic,消费者可以消费该topic中所有的数据,同一条数据可以被多个消费者消费,数据被消费后不会立马删除。在发布-订阅消息系统中,消息的生产者称为发布者,消费者称为订阅者。该模式的示例图如下:
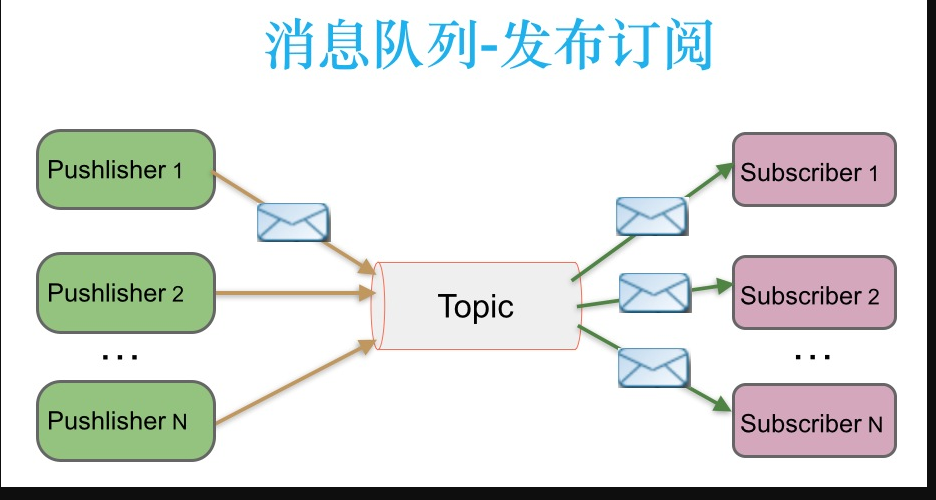
发布者发送到topic的消息,只有订阅了topic的订阅者才会收到消息。
二、Kafka的优点
2.1 解耦
在项目启动之初来预测将来项目会碰到什么需求,是极其困难的。消息系统在处理过程中间插入了一个隐含的、基于数据的接口层,两边的处理过程都要实现这一接口。这允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束。
2.2 冗余(副本)
有些情况下,处理数据的过程会失败。除非数据被持久化,否则将造成丢失。消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失风险。许多消息队列所采用的"插入-获取-删除"范式中,在把一个消息从队列中删除之前,需要你的处理系统明确的指出该消息已经被处理完毕,从而确保你的数据被安全的保
原创不易,完成人机校验,阅读全文