Java面试集锦(一)之秒杀系统设计
秒杀系统设计
1.主要做到以下两点:
尽量将请求过滤在上游。
尽可能的利用缓存(大多数场景下都是查多于写)。
如果流量巨大,导致各个层的压力都很大可以适当的加机器横向扩容。如果加不了机器那就只有放弃流量直接返回失败。快速失败非常重要,至少可以保证系统的可用性。
业务分批执行:对于下单、付款等操作可以异步执行提高吞吐率。
主要目的就是尽量少的请求直接访问到 DB。
2. 架构图
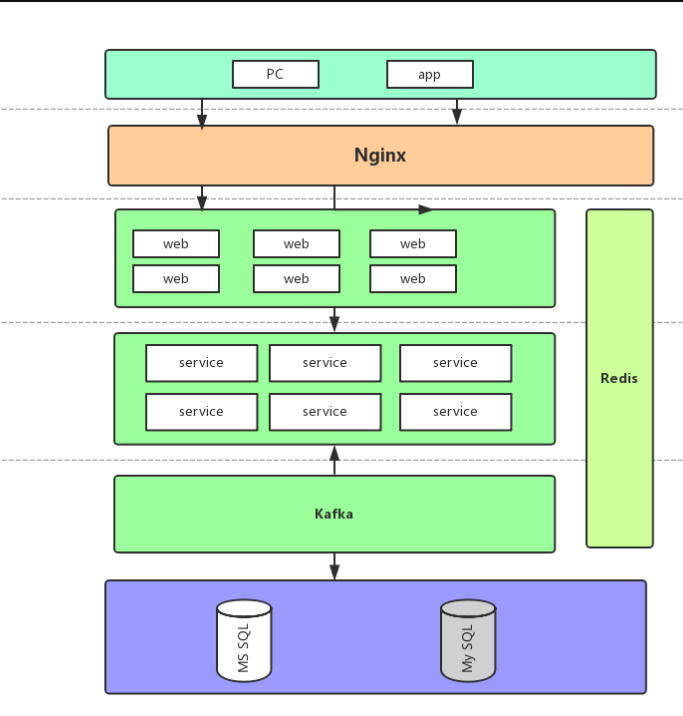
前端请求进入 web 层,对应的代码就是 controller。
之后将真正的库存校验、下单等请求发往 Service 层(其中 RPC 调用依然采用的 dubbo,只是更新为最新版本,本次不会过多讨论 dubbo 相关的细节,有兴趣的可以查看 基于dubbo的分布式架构)。
Service 层再对数据进行落地,下单完成
其实抛开秒杀这个场景来说正常的一个下单流程可以简单分为以下几步:
校验库存
扣库存
创建订单
支付
3.常见问题
3.1 超卖现象(使用乐观锁更新)
3.2 提高吞吐量
为了进一步提高秒杀时的吞吐量以及响应效率,这里的 web 和 Service 都进行了横向扩展。
web 利用 Nginx 进行负载。
Service 也是多台应用
当并发量达到几百万时(分布式限流)
我们将并发控制在一个可控的范围之内,然后快速失败这样就能最大程度的保护系统。
3.3 sql查询太多(redis缓存)
这种数据我们完全可以放在内存中,效率比在数据库要高很多。
由于我们的应用是分布式的,所以堆内缓存显然不合适,Redis 就非常适合。
这次主要改造的是 Service 层:
每次查询库存时走 Redis。
扣库存时更新 Redis。
需要提前将库存信息写入 Redis(手动或者程序自动都可以)。
3.4请求同步转异步(kafka)
这里我们将写订单以及更新库存的操作进行异步化,利用 Kafka 来进行解耦和队列的作用。
每当一个请求通过了限流到达了 Service 层通过了库存校验之后就将订单信
原创不易,完成人机校验,阅读全文