Java面试集锦(一)之Java集合
Java集合
1.集合
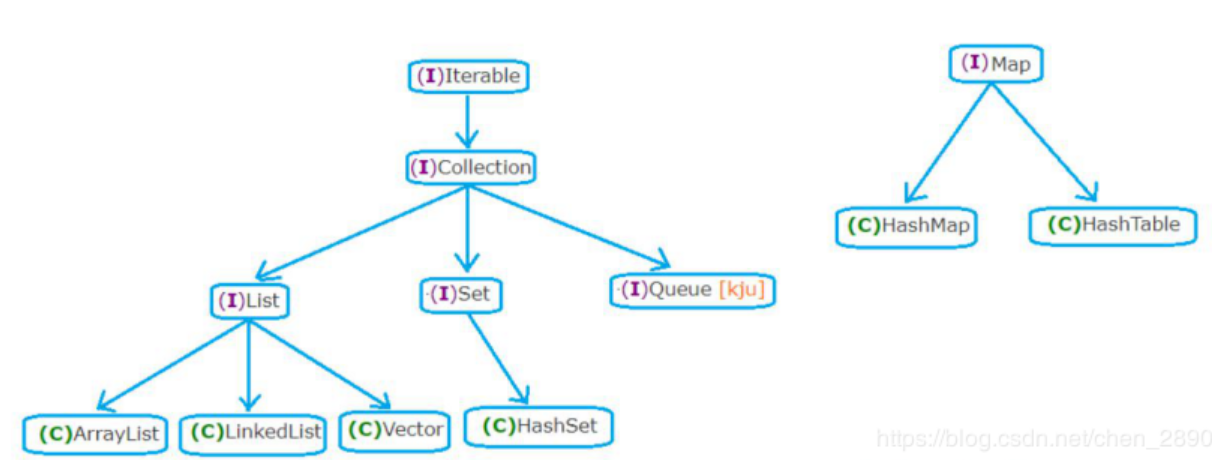
1. List:有序、可重复。可以通过索引快速查找,但进行增删操作时后续的数据需要移动,所以增删速度慢。
2. Set:无序、不可重复。
3. Map:键值对、键唯一、值不唯一。Map 集合中存储的是键值对,键不能重复,值可以重复。根据键得到值,对 map 集合遍历时先得到键的 set 集合,对 set 集合进行遍历,得到相应的值。
4. ArrayList: ArrayList 实现于 List、RandomAccess 接口,具有list的特性,有序,可以重复,并且可以插入空数据,也支持随机访问。ArrayList相当于动态数据(动态数组),其中最重要的两个属性分别是: elementData 数组,以及 size 大小,ArrayList 的主要消耗是数组扩容来在指定位置添加数据。增删是数组复制的过程,效率比较慢,但查询比较快。
5. Vector: Vector 也是实现于 List 接口,底层数据结构和 ArrayList 类似,也是一个动态数组存放数据。不过是在 add() 方法的时候使用 synchronized 进行同步写数据,但是开销较大,所以 Vector 是一个同步容器并不是一个并发容器。
6. LinkedList: LinkedList 底层是基于双向链表实现的,也是实现了 List 接口,所以也拥有 List 的一些特点, 可见每次插入都是移动指针,和 ArrayList 的拷贝数组来说效率要高上不少。
LinkedList 插入,删除都是移动指针效率很高。
查找需要进行遍历查询,效率较低。
7. HashSet: HashSet 实现了list接口,具有list的一些特点,是一个不允许存储重复元素的集合,它的实现比较简单,只要理解了 HashMap,HashSet 就水到渠成了。比较关键的就是这个 add() 方法。 可以看出它是将存放的对象当做了 HashMap 的健,value 都是相同的 。由于 HashMap 的 key 是不能重复的,所以每当有重复的值写入到 HashSet 时,value 会被覆盖,但 key 不会受到影响,这样就保证了 HashSet 中只能存放不重复的元素。
HashSet 的原理比较简单,几乎全部借助于 HashMap 来实现的。
所以 HashMap 会出现的问题 HashSet 依然不能避免。
8. HashMap: HashMap 底层是基于数组和链表实现的
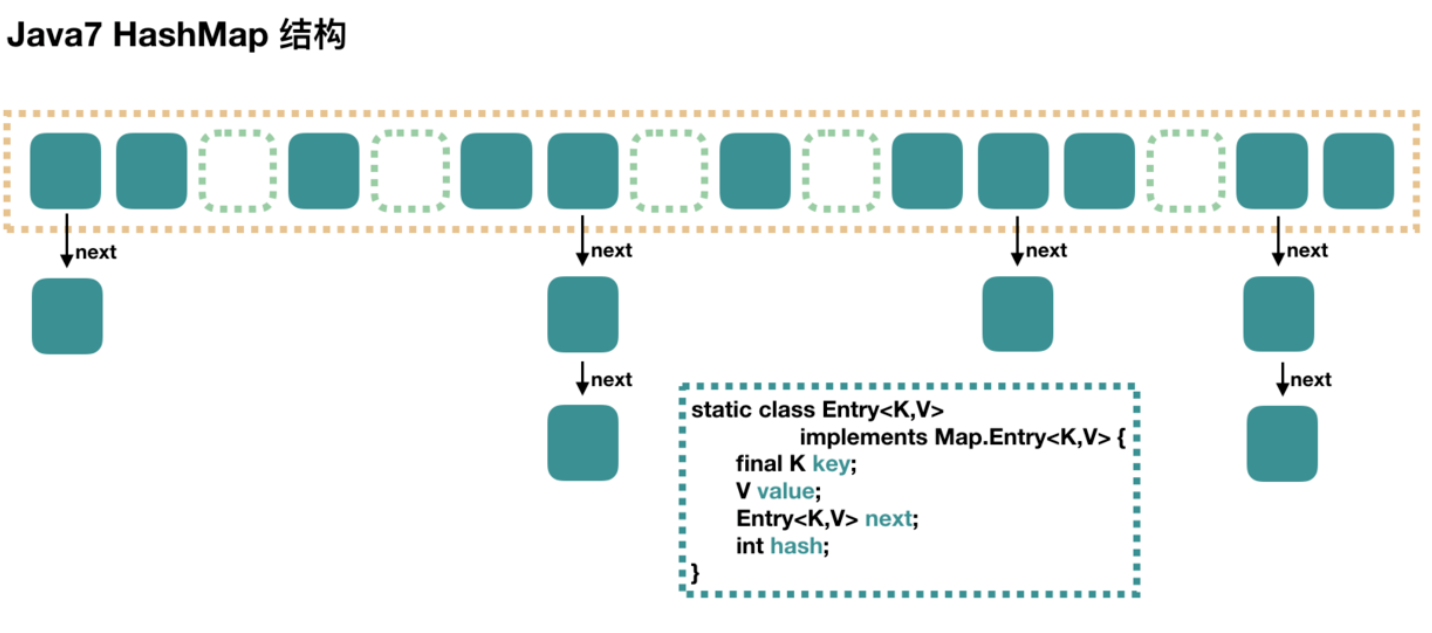 每个绿色的实体是嵌套类 Entry 的实例,Entry 包含四个属性:key, value, hash 值和用于单向链表的 next。
根据 Java7 HashMap 的介绍,我们知道,查找的时候,根据 hash 值我们能够快速定位到数组的具体下标,但是之后的话,需要顺着链表一个个比较下去才能找到我们需要的,时间复杂度取决于链表的长度,为 O(n)。
为了降低这部分的开销,在 Java8 中,当链表中的元素超过了 8 个以后,会将链表转换为红黑树,在这些位置进行查找的时候可以降低时间复杂度为 O(logN)。
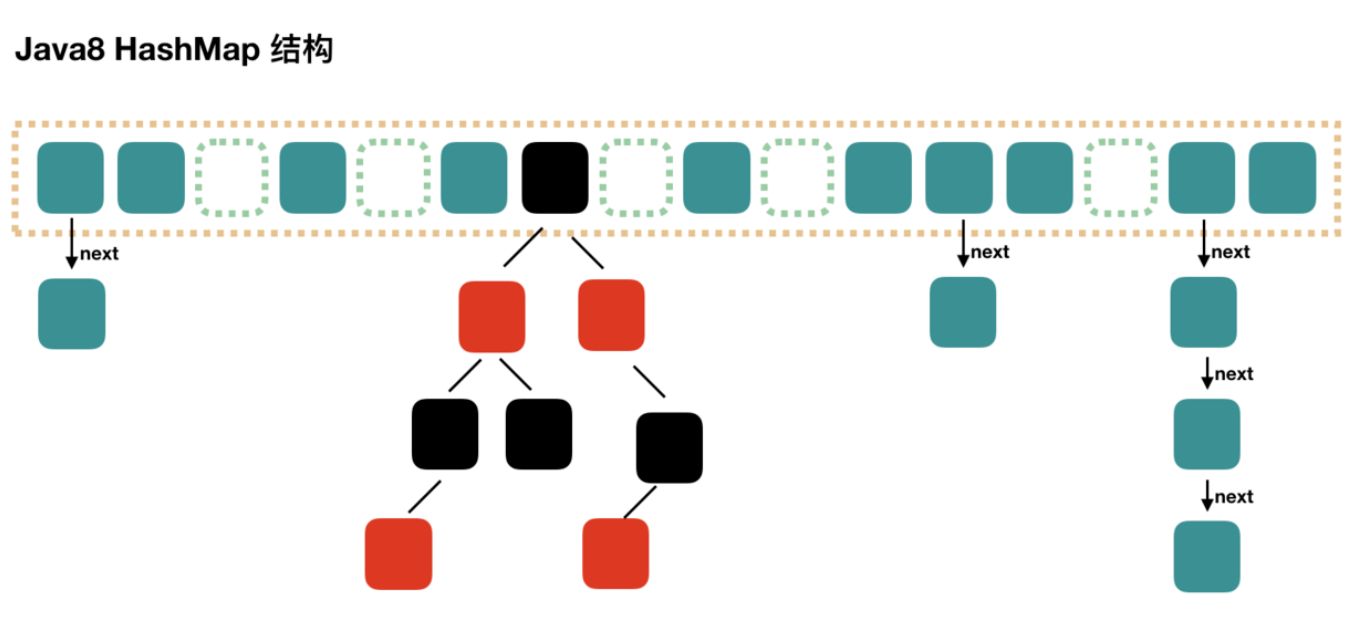
Java7 中使用 Entry 来代表每个 HashMap 中的数据节点,Java8 中使用 Node,基本没有区别,都是 key,value,hash 和 next 这四个属性,不过,Node 只能用于链表的情况,红黑树的情况需要使用 TreeNode。
其中有两个重要的参数
容量
负载因子
容量的默认大小是 16,负载因子是 0.75,当 HashMap 的 size > 16*0.75 时就会发生扩容(容量和负载因子都可以自由调整)。
由于数组的长度有限,所以难免会出现不同的 Key 通过运算得到的 index 相同,这种情况可以利用链表来解决,
在并发环境下使用 HashMap 容易出现死循环。
并发场景发生扩容,调用 resize() 方法里的 rehash() 时,容易出现环形链表。这样当获取一个不存在的 key时,计算出的 index 正好是环形链表的下标时就会出现死循环。 所以 HashMap 只能在单线程中使用,并且尽量的预设容量,尽可能的减少扩容。
9. LinkedHashMap:它的底层是继承于 HashMap 实现的,由一个双向链表所构成。
LinkedHashMap 的排序方式有两种:
根据写入顺序排序。
根据访问顺序排序。
其中根据访问顺序排序时,每次 get 都会将访问的值移动到链表末尾,这样重复操作就能得到一个按照访问顺序排序的链表。总的来说 LinkedHashM
原创不易,完成人机校验,阅读全文