Java面试集锦(一)之Redis
1. 为啥在项目里要用缓存呢
用缓存,主要是俩用途,高性能和高并发
高性能
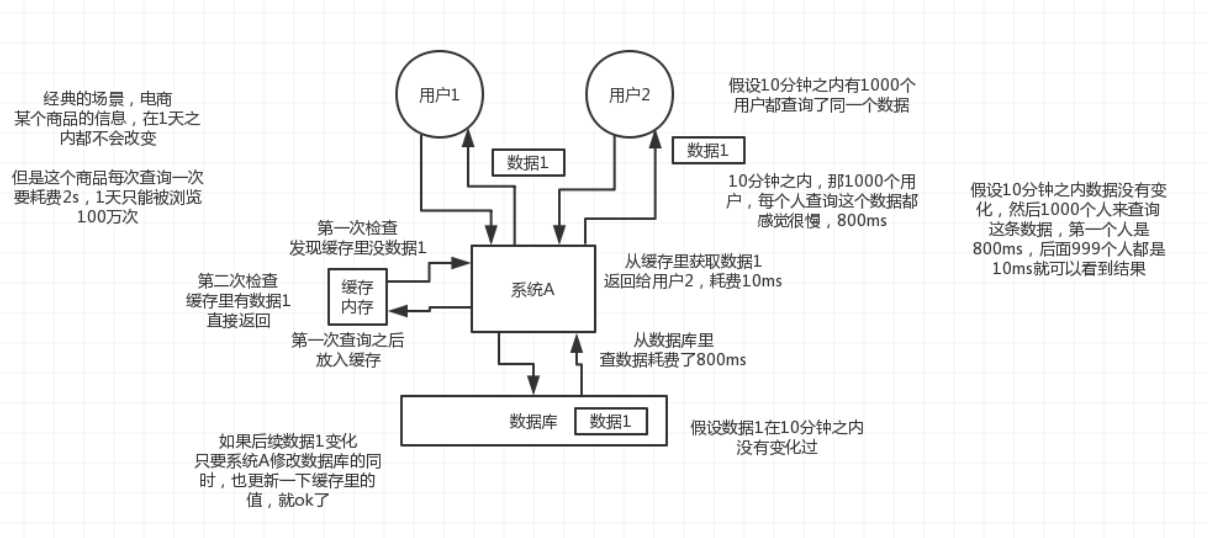
高并发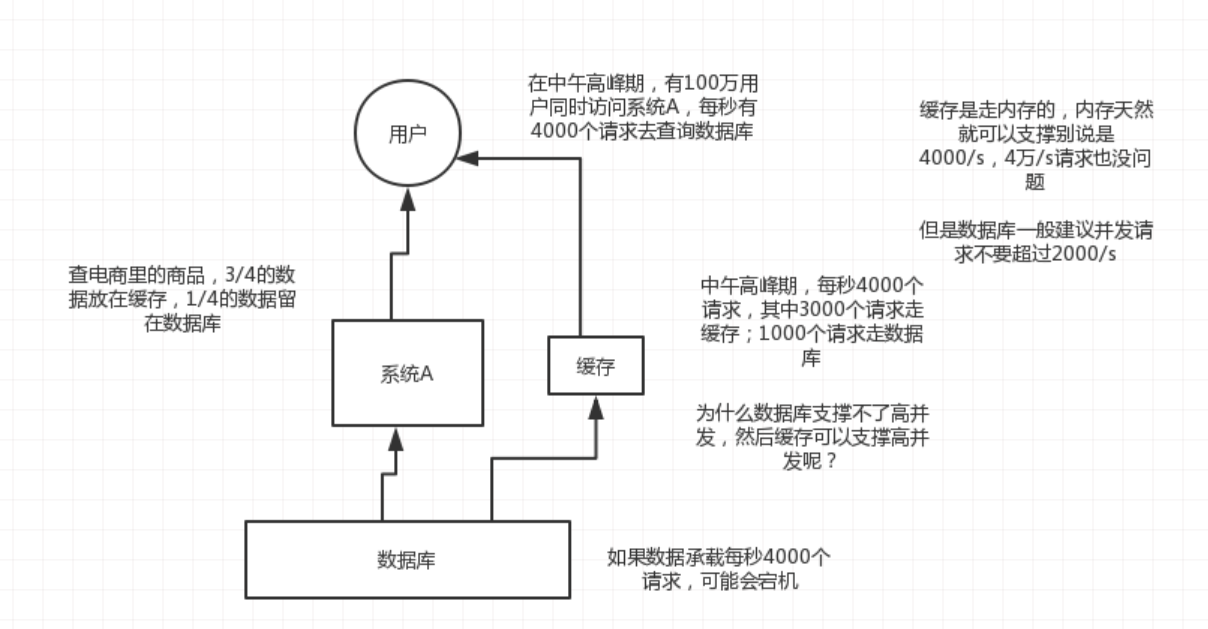
2.介绍
Redis 是一个开源的使用 ANSI C 语言编写、遵守 BSD 协议、支持网络、可基于内存亦可持久化的日志型、Key-Value 数据库,并提供多种语言的 API的非关系型数据库。
传统数据库(关系型数据库)遵循 ACID 规则。而 Nosql(非关系型数据库)(Not Only SQL 的缩写,是对不同于传统的关系型数据库的数据库管理系统的统称) 一般为分布式,而分布式一般遵循 CAP 定理。
CAP理论
C:consistency(一致性)
A:avalibility(可用性)
P:Partition(分区)-tolerence to partition(分区容忍度)
分区:一个分布式系统,网络不通讯,导致连接不通,系统被分割成几个数据区域
原因:数据不连通了,产生数据分区
影响:
查还好一点
数据修改时,必须要求数据一致--加锁,实现数据一致性【需求要求数据一致性】
数据修改时,可以数据不一致--不用加锁【需求不要求数据一致性】
分区容忍度
数据的一致性要求高,容忍度高,加锁
数据的一致性要求低,容忍度低,可以不加锁
预期结果,保持数据的一致
可用性
请求在一定时间段内都应该有响应
为了解决锁一直加着
CP理论:【一致性+分区】数据的一致性要求高-加锁
AP理论:【可用性+分区】数据的一致性要求低-不加锁
CAP总结
分区是常态,可不避免,三者不可共存
可用性和一致性是一对冤家
一致性高,可用性低
一致性低,可用性高
3. 为什么说redis能够快速执行
绝大部分请求是纯粹的内存操作(非常快速)
采用单线程,避免了不必要的上下文切换和竞争条件
非阻塞IO - IO多路复用
4. Redis支持的数据类型?
String字符串:
格式: set key value
string类型是二进制安全的。意思是redis的string可以包含任何数据。比如jpg图片或者序列化的对象 。
string类型是Redis最基本的数据类型,一个键最大能存储512MB。
Hash(哈希)
key=150
value={
“id”: 150,
“name”: “zhangsan”,
“age”: 20
}
hash类的数据结构,主要是用来存放一些对象,把一些简单的对象给缓存起来,后续操作的时候,你可以直接仅仅修改这个对象中的某个字段的值
格式: hmset name key1 value1 key2 value2
Redis hash 是一个键值(key=>value)对集合。
Redis hash是一个string类型的field和value的映射表,hash特别适合用于存储对象。
List(列表)
key=某大v
value=[zhangsan, lisi, wangwu]
比如可以通过list存储一些列表型的数据结构,类似粉丝列表了、文章的评论列表了之类的东西
Redis 列表是简单的字符串列表,按照插入顺序排序。你可以添加一个元素到列表的头部(左边)或者尾部(右边)
格式: lpush name value
在 key 对应 list 的头部添加字符串元素
格式: rpush name value
在 key 对应 list 的尾部添加字符串元素
格式: lrem name index
key 对应 list 中删除 count 个和 value 相同的元素
格式: llen name
返回 key 对应 list 的长度
Set(集合)
可以基于set玩儿交集、并集、差集的操作,比如交集吧,可以把两个人的粉丝列表整一个交集,看看俩人的共同好友是谁
格式: sadd name value
Redis的Set是string类型的无序集合。
集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是O(1)。
zset(sorted set:有序集合)
格式: zadd name score value
Redis zset 和 set 一样也是string类型元素的集合,且不允许重复的成员。
不同的是每个元素都会关联一个double类型的分数。redis正是通过分数来为集合中的成员进行从小到大的排序。
zset的成员是唯一的,但分数(score)却可以重复。
比如说你要是想根据时间对数据排序,那么可以写入进去的时候用某个时间作为分数,人家自动给你按照时间排序了
排行榜:将每个用户以及其对应的什么分数写入进去,zadd board score username,接着zrevrange board 0 99,就可以获取排名前100的用户;zrank board username,可以看到用户在排行榜里的排名
5.什么是Redis持久化?Redis有哪几种持久化方式?优缺点是什么?
持久化就是把内存的数据写到磁盘中去,防止服务宕机了内存数据丢失。
Redis 提供了两种持久化方式:RDB(默认) 和AOF RDB内存快照和AOF日志文件
RDB(快照的方式):
生成一个文件,便于复制,移动,性能比较好
rdb是Redis DataBase缩写
功能核心函数rdbSave(生成RDB文件)和rdbLoad(从文件加载内存)两个函数
AOF:
Aof是Append-only file缩写
每当执行服务器(定时)任务或者函数时flushAppendOnlyFile 函数都会被调用, 这个函数执行以下两个工作
aof写入保存:
WRITE:根据条件,将 aof_buf 中的缓存写入到 AOF 文件
SAVE:根据条件,调用 fsync 或 fdatasync 函数,将 AOF 文件保存到磁盘中。
存储结构:
内容是redis通讯协议(RESP )格式的命令文本存储。
比较:
1、aof文件比rdb更新频率高,优先使用aof还原数据。
2、aof比rdb更安全也更大
3、rdb性能比aof好
4、如果两个都配了优先加载AOF
6. redis的底层数据结构
redis底层有6种数据结构,分别是简单动态字符串(SDS),链表,字典,跳跃表,整数集合,压缩列表。
跳跃表
Redis
原创不易,完成人机校验,阅读全文