数据库分库分表思路
一. 数据切分
1、垂直(纵向)切分
2、水平(横向)切分
二. 分库分表带来的问题
1、事务一致性问题
2、跨节点关联查询 join 问题
3、跨节点分页、排序、函数问题
4、全局主键避重问题
5、数据迁移、扩容问题
三. 什么时候考虑切分
1、能不切分尽量不要切分
2、数据量过大,正常运维影响业务访问
3、随着业务发展,需要对某些字段垂直拆分
4、数据量快速增长
5、安全性和可用性
四. 案例分析
1、用户中心业务场景
2、水平切分方法
3、非uid的查询方法
五. 支持分库分表中间件
一. 数据切分
关系型数据库本身比较容易成为系统瓶颈,单机存储容量、连接数、处理能力都有限。当单表的数据量达到1000W或100G以后,由于查询维度较多,即使添加从库、优化索引,做很多操作时性能仍下降严重。此时就要考虑对其进行切分了,切分的目的就在于减少数据库的负担,缩短查询时间。
数据库分布式核心内容无非就是数据切分(Sharding),以及切分后对数据的定位、整合。数据切分就是将数据分散存储到多个数据库中,使得单一数据库中的数据量变小,通过扩充主机的数量缓解单一数据库的性能问题,从而达到提升数据库操作性能的目的。
数据切分根据其切分类型,可以分为两种方式:垂直(纵向)切分和水平(横向)切分
1、垂直(纵向)切分
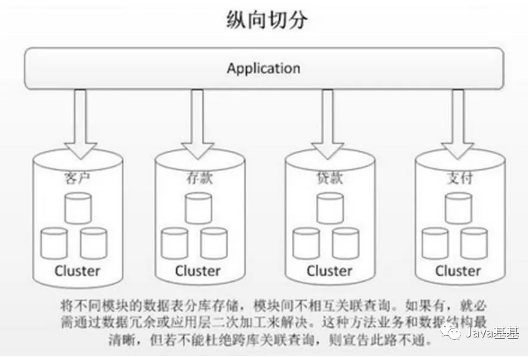
垂直切分常见有垂直分库和垂直分表两种。
垂直分库就是根据业务耦合性,将关联度低的不同表存储在不同的数据库。做法与大系统拆分为多个小系统类似,按业务分类进行独立划分。与"微服务治理"的做法相似,每个微服务使用单独的一个数据库。如图:
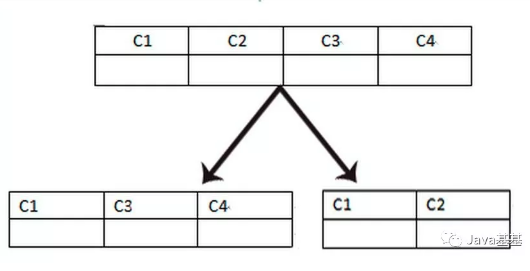
垂直分表是基于数据库中的"列"进行,某个表字段较多,可以新建一张扩展表,将不经常用或字段长度较大的字段拆分出去到扩展表中。
在字段很多的情况下(例如一个大表有100多个字段),通过"大表拆小表",更便于开发与维护,也能避免跨页问题,MySQL底层是通过数据页存储的,一条记录占用空间过大会导致跨页,造成额外的性能开销。
另外数据库以行为单位将数据加载到内存中,这样表中字段长度较短且访问频率较高,内存能加载更多的数据,命中率更高,减少了磁盘IO,从而提升了数据库性能。
垂直切分的优点:
解决业务系统层面的耦合,业务清晰
与微服务的治理类似,也能对不同业务的数据进行分级管理、维护、监控、扩展等
高并发场景下,垂直切分一定程度的提升IO、数据库连接数、单机硬件资源的瓶颈
缺点:
部分表无法join,只能通过接口聚合方式解决,提升了开发的复杂度
分布式事务处理复杂
依然存在单表数据量过大的问题(需要水平切分)
2、水平(横向)切分
当一个应用难以再细粒度的垂直切分,或切分后数据量行数巨大,存在单库读写、存储性能瓶颈,这时候就需要进行水平切分了。
水平切分分为库内分表和分库分表,是根据表内数据内在的逻辑关系,将同一个表按不同的条件分散到多个数据库或多个表中,每个表中只包含一部分数据,从而使得单个表的数据量变小,达到分布式的效果。如图所示:
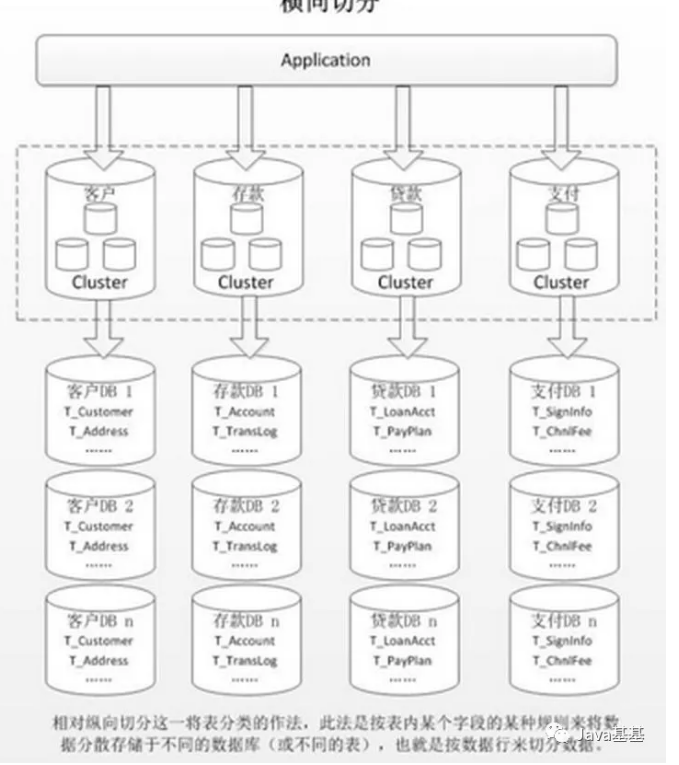
库内分表只解决了单一表数据量过大的问题,但没有将表分布到不同机器的库上,因此对于减轻MySQL数据库的压力来说,帮助不是很大,大家还是竞争同一个物理机的CPU、内存、网络IO,最好通过分库分表来解决。
水平切分的优点:
不存在单库数据量过大、高并发的性能瓶颈,提升系统稳定性和负载能力
应用端改造较小,不需要拆分业务模块
缺点:
跨分片的事务一致性难以保证
跨库的join关联查询性能较差
数据多次扩展难度和维护量极大
水平切分后同一张表会出现在多个数据库/表中,每个库/表的内容不同。几种典型的数据分片规则为:
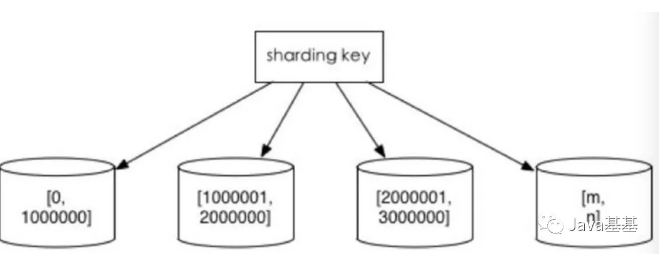
1、根据数值范围
按照时间区间或ID区间来切分。例如:按日期将不同月甚至是日的数据分散到不同的库中;将userId为19999的记录分到第一个库,1000020000的分到第二个库,以此类推。某种意义上,某些系统中使用的"冷热数据分离",将一些使用较少的历史数据迁移到其他库中,业务功能上只提供热点数据的查询,也是类似的实践。
这样的优点在于:
单表大小可控
天然便于水平扩展,后期如果想对整个分片集群扩容时,只需要添加节点即可,无需对其他分片的数据进行迁移
使用分片字段进行范围查找时,连续分片可快速定位分片进行快速查询,有效避免跨分片查询的问题。
缺点:
热点数据成为性能瓶颈。连续分片可能存在数据热点,例如按时间字段分片,有些分片存储最近时间段内的数据,可能会被频繁的读写,而有些分片存储的历史数据,则很少被查询
2、根据数值取模
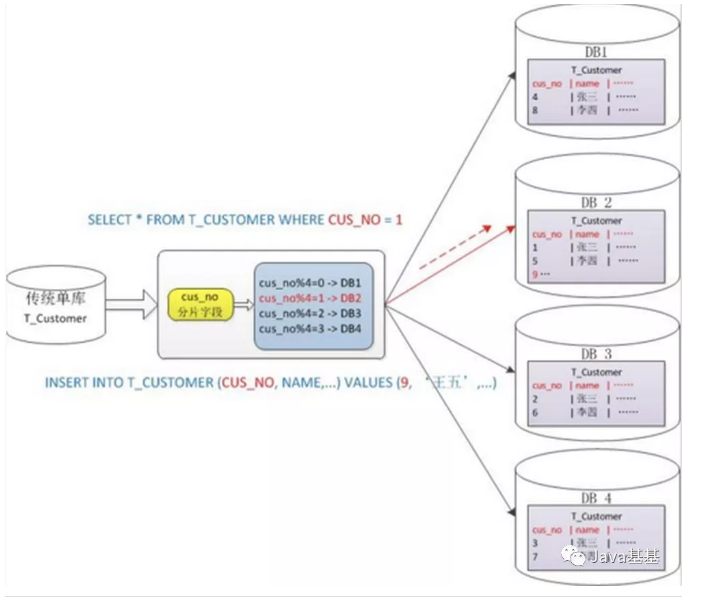
一般采用hash取模mod的切分方式,例如:将 Customer 表根据 cusno 字段切分到4个库中,余数为0的放到第一个库,余数为1的放到第二个库,以此类推。这样同一个用户的数据会分散到同一个库中,如果查询条件带有cusno字段,则可明确定位到相应库去查询。
优点:
数据分片相对比较均匀,不容易出现热点和并发访问的瓶颈
缺点:
后期分片集群扩容时,需要迁移旧的数据(使用一致性hash算法能较好的避免这个问题)
容易面临跨分片查询的复杂问题。比如上例中,如果频繁用到的查询条件中不带cusno时,将会导致无法定位数据库,从而需要同时向4个库发起查询,再在内存中合并数据,取最小集返回给应用,分库反而成为拖累。
二. 分库分表带来的问题
分库分表能有效的环节单机和单库带来的性能瓶颈和压力,突破网络IO、硬件资源、连接数的瓶颈,同时也带来了一些问题。下面将描述这些技术挑战以及对应的解决思路。
1、事务一致性问题
分布式事务
当更新内容同时分布在不同库中,不可避免会带来跨库事务问题。跨分片事务也是分布式事务,没有简单的方案,一般可使用"XA协议"和"两阶段提交"处理。
分布式事务能最大限度保证了数据库操作的原子性。但在提交事务时需要协调多个节点,推后了提交事务的时间点,延长了事务的执行时间。导致事务在访问共享资源时发生冲突或死锁的概率增高。随着数据库节点的增多,这种趋势会越来越严重,从而成为系统在数据库层面上水平扩展的枷锁。
最终一致性
对于那些性能要求很高,但对一致性要求不高的系统,往往不苛求系统的实时一致性,只要在允许的时间段内达到最终一致性即可,可采用事务补偿的方式。与事务在执行中发生错误后立即回滚的方式不同,事务补偿是一种事后检查补救的措施,一些常见的实现方法有:对数据进行对账检查,基于日志进行对比,定期同标准数据来源进行同步等等。事务补偿还要结合业务系统来考虑。
2、跨节点关联查询 join 问题
切分之前,系统中很多列表和详情页所需的数据可以通过sql join来完成。而切分之后,数据可能分布在不同的节点上,此时join带来的问题就比较麻烦了,考虑到性能,尽量避免使用join查询。
解决这个问题的一些方法:
1)全局表
全局表,也可看做是"数据字典表",就是系统中所有模块都可能依赖的一些表,为了避免跨库join查询,可以将这类表在每个数据库中都保存一份。这些数据通常很少会进行修改,所以也不担心一致性的问题。
2)字段冗余
一种典型的反范式设计,利用空间换时间,为了性能而避免join查询。例如:订单表
原创不易,完成人机校验,阅读全文