分库分表之后,ID主键如何处理?
分库分表之后,ID主键如何处理?当业务量大的时候,数据库中数据量过大,就要进行分库分表了,那么分库分表之后,必然将面临一个问题,那就是ID怎么生成?因为要分成多个表之后,如果还是使用每个表的自增长ID,意味着每个表都是从1开始累加的,这样肯定是不对的。需要一个全局唯一的ID来支持。所以这也是你实际生产环境中必须考虑的一个问题。全局ID生成器,一般需要满足下列几个特性:唯一性、高可用、递增性、安全性
当业务量大的时候,数据库中数据量过大,就要进行分库分表了,那么分库分表之后,必然将面临一个问题,那就是ID怎么生成?因为要分成多个表之后,如果还是使用每个表的自增长ID,意味着每个表都是从1开始累加的,这样肯定是不对的。需要一个全局唯一的ID来支持。所以这也是你实际生产环境中必须考虑的一个问题。全局ID生成器,一般需要满足下列几个特性:
唯一性、高可用、递增性、安全性、高可用性
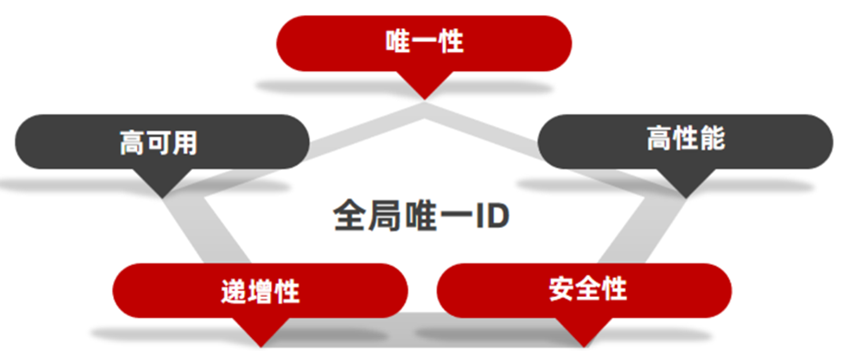
常用的主键ID生成策略有以下几种:
数据库自增ID
原理:
如果使用这种方式,那么这就意味着,你的系统里每次得到一个ID,都需要往一个库中的一个表中插入一条没有什么业务含义的数据,然后获取一个数据库自增的id.拿到这个ID之后,再往对应的分库分表里写。
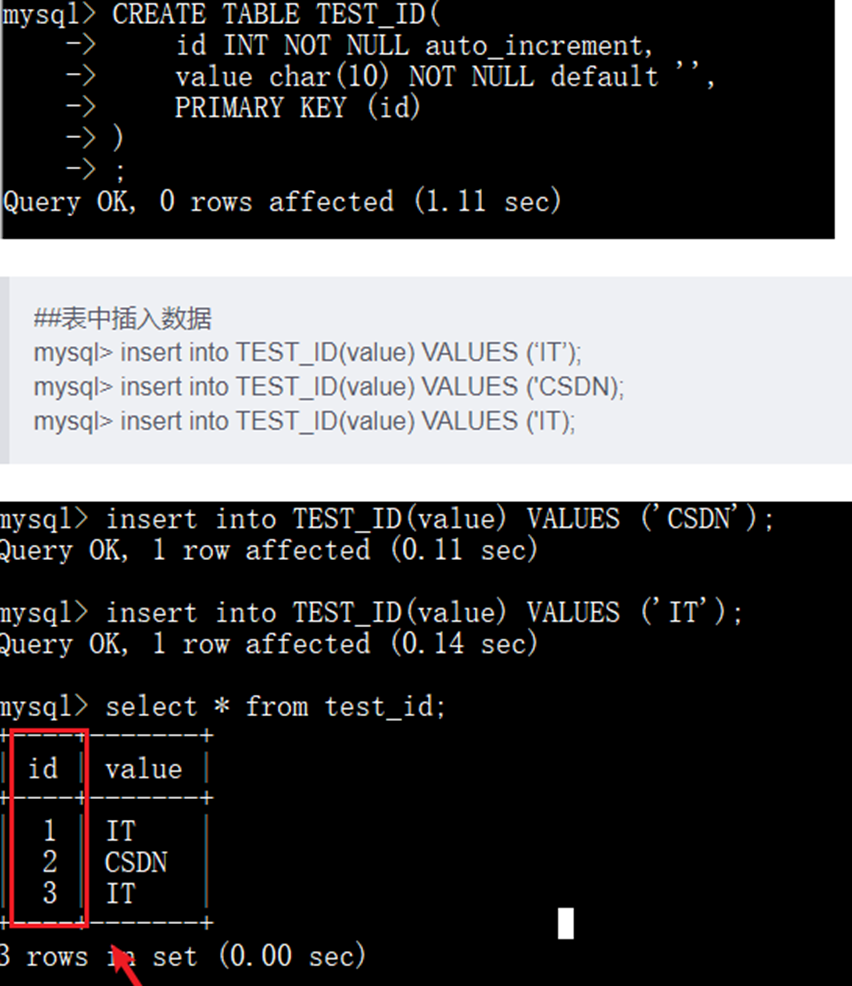
这种方式的优缺点如下:
优点:非常简单,有序递增,方便分页和排序。
缺点:
a.分库分表之后,数据表的自增ID容易重复,无法直接使用(虽然可以设置步长,但是局限性明显);
b.性能吞吐量整个比较低。如果设计一个单独的数据库来实现分布式应用的数据唯一性,即使使用预先生成方案,也会因为事务问题,在高并发场景下容易出现单点的瓶颈问题。
使用场景:单数据库实例的表ID(包含主从同步场景);部分按天计数的流水号等
在分不分表场景、全局唯一性ID场景下不使用。
Redis
原创不易,完成人机校验,阅读全文