Redis实战9-全局唯一ID
发布优惠券的时候,每个店铺都可以发布优惠券,当用户抢购的时候,优惠券表中的id如果使用数据库的自增长ID会存在以下问题:1:id的规律太明显,容易被刷2:当数据量很大的时候,会受到单表数据的限制缺点场景分析:id规律场景:如果我们的id具有太明显的规则,用户或者说商业对手很容易猜测出来我们的一些敏感信息,比如商城在一天时间内,卖出了多少单,这明显不合适。单表限制:随着我们商城规模越来越大,mysq
发布优惠券的时候,每个店铺都可以发布优惠券,当用户抢购的时候,优惠券表中的id如果使用数据库的自增长ID会存在以下问题:
id规律场景:如果我们的id具有太明显的规则,用户或者说商业对手很容易猜测出来我们的一些敏感信息,比如商城在一天时间内,卖出了多少单,这明显不合适。
单表限制:随着我们商城规模越来越大,mysql的单表的容量不宜超过500W,数据量过大之后,我们要进行拆库拆表,但拆分表了之后,他们从逻辑上讲他们是同一张表,所以他们的id是不能一样的, 于是乎我们需要保证id的唯一性。
全局ID生成器
全局ID生成器,是一种在分布式系统下用来生成全局唯一的ID工具,一般需要瞒住下列特性:
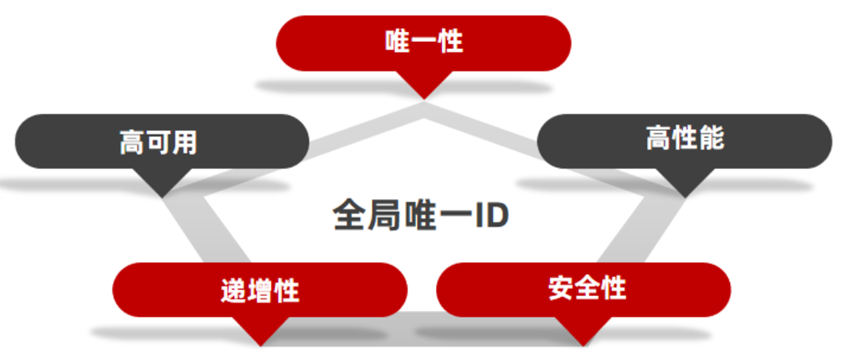
全局唯一ID生成策略:
实战:基于Redis拼接其他信息来实现全局唯一ID
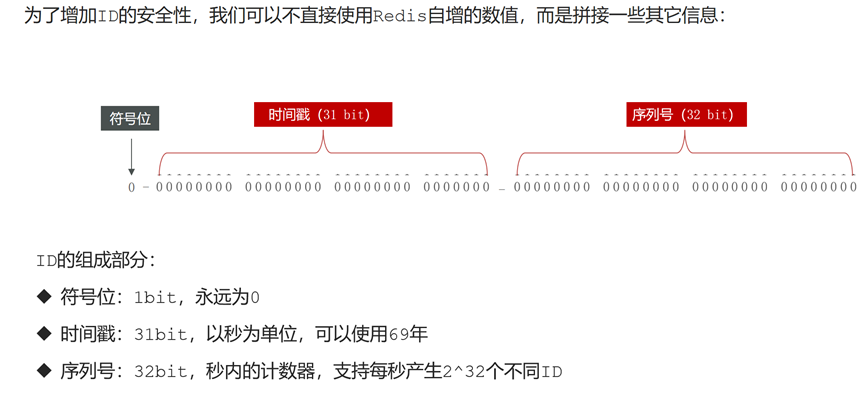
全局唯一ID使用long类型的,其中时间戳是基于某一个时间点开始的。比如我们从2022.11.26 23:00:00开始,可以使用69年。

思考2:时间戳,怎么计算的?
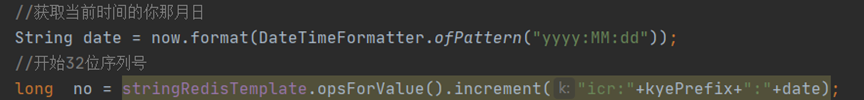
思考4:怎么拼接?
因为我们需要返回的是long类型的,如果使用string拼接后,还要转换。还要知道,使用string拼接,当并发量很大的时候,也会有性能问题。那么我们应该怎么处理的?
注意:我们再来看看全局唯一ID的格式。如上图,我们可以看出,共64位,其中符号位是1个,时间戳是31位。序列号是32位,发现什么了吗?如果我们把时间戳向左移动32位(因为序列号是32位。向左移动位置,空出给序列号使用),是不是就是符号位+时间戳的了?
2:我们还需要知道,在计算机中 | 或计算:按位或运算“|”
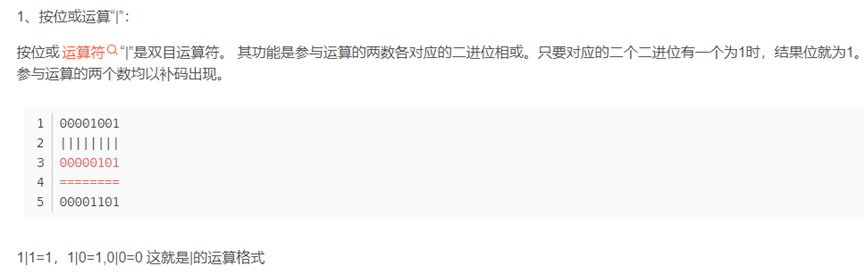
根据上面,我们可以知道位运算序号后,就是序列号的值。序列号是多少,就是多少。
所以,我们可以知道拼接代码如下:timeStamp << 32 |no;
import org.springframework.data
原创不易,完成人机校验,阅读全文