Java面试集锦(一)之数据库(mysql)
数据库(mysql)
1. 数据库范式
第一范式:列不可分,eg:【联系人】(姓名,性别,电话),一个联系人有家庭电话和公司电话,那么这种表结构设计就没有达到 1NF;
第二范式:有主键,保证完全依赖。eg:订单明细表【OrderDetail】(OrderID,ProductID,UnitPrice,Discount,Quantity,ProductName),Discount(折扣),Quantity(数量)完全依赖(取决)于主键(OderID,ProductID),而 UnitPrice,ProductName 只依赖于 ProductID,不符合2NF;
第三范式:无传递依赖(非主键列 A 依赖于非主键列 B,非主键列 B 依赖于主键的情况),eg:订单表【Order】(OrderID,OrderDate,CustomerID,CustomerName,CustomerAddr,CustomerCity)主键是(OrderID),CustomerName,CustomerAddr,CustomerCity 直接依赖的是 CustomerID(非主键列),而不是直接依赖于主键,它是通过传递才依赖于主键,所以不符合 3NF。
2.连接查询
分类:内连接、外连接、自然连接(略)、交叉连接(略)
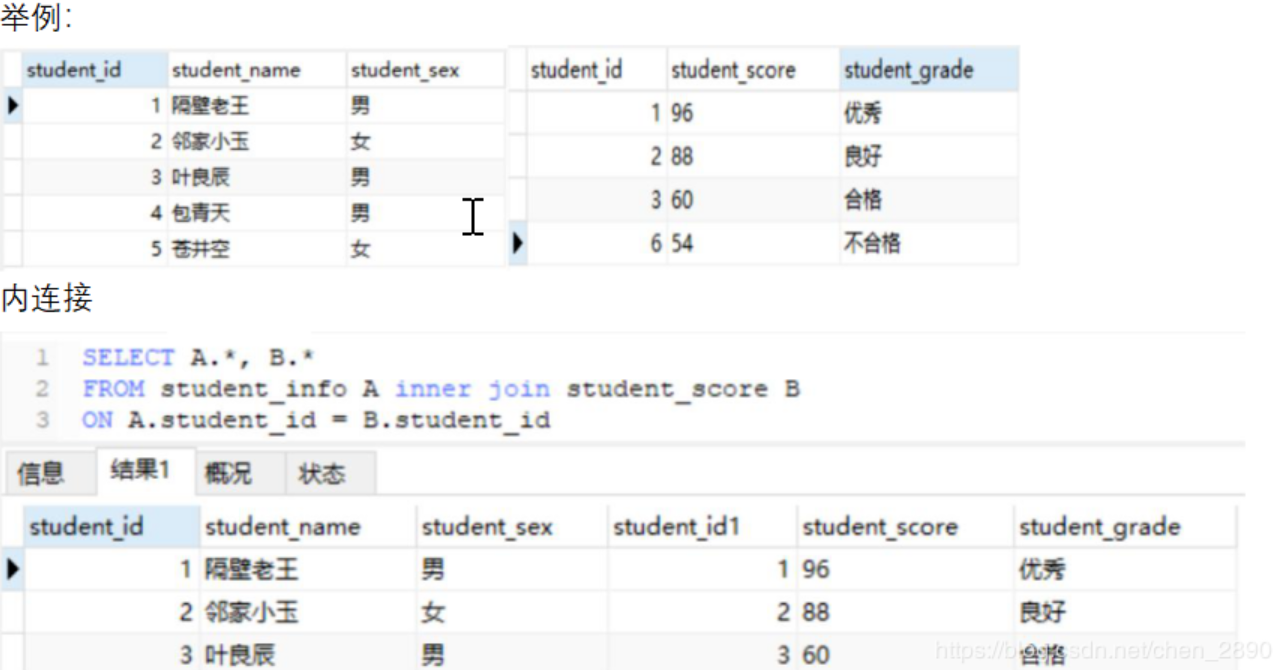
内连接
基本语法:左表 [inner] join 右表 on 左表.字段 = 右表.字段;
从左表中取出每一条记录,去右表中与所有的记录进行匹配:匹配必须是某个条件在左表中与右表中相同最终才会保留结果,否则不保留。
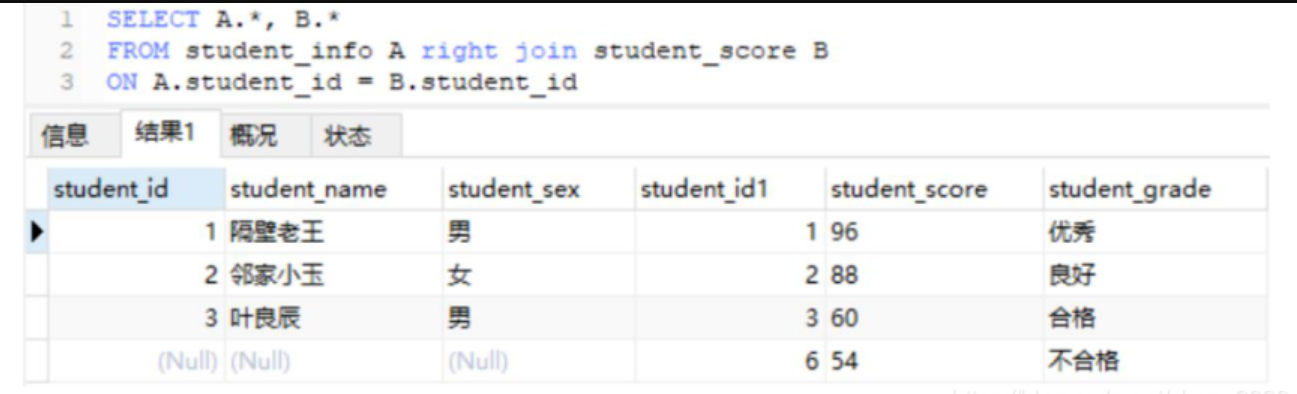
外连接
基本语法: 左表 left/right join 右表 on 左表.字段 = 右表.字段;
left join: 左外连接(左连接), 以左表为主表
right join: 右外连接(右连接), 以右表为主
举例
内连接
左外连接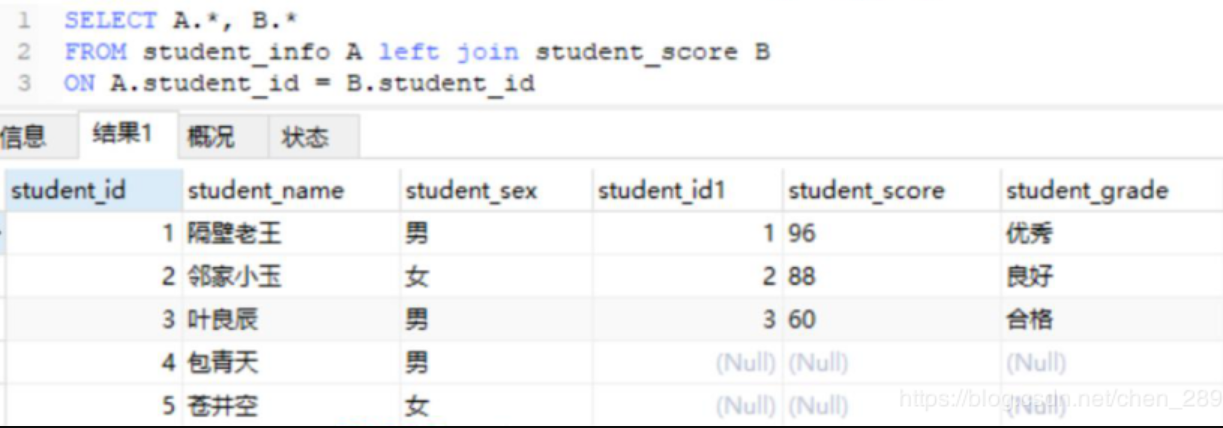
右外连接
3.联合查询
基本语法:
    Select 语句 1
    Union [union 选项]
    Select 语句 2

    ……
将多次查询(多条 select 语句), 在记录上进行拼接(字段不会增加),每一条 select 语句获取的字段数必须严格一致(但是字段类型无关)。
其中 union 选项有 2 个。ALL:保留所有;Distinct(默认):去重。
应用:查询同一张表,但是有不同的需求;查询多张表,多张表的结构完全一致,保存的数据也是一样的。
在联合查询中,order by 不能直接使用。需要对查询语句使用括号才行。另外需要配合 limit 使用
order by(排序)
select 字段列表/* from 表名 where 条件 order by 字段名1 asc(升序 默认)/desc(降序),
举例
SELECT
( SELECT d.dept_name FROM departments d WHERE de.dept_no = d.dept_no ) AS 部门,
count( de.emp_no ) AS 人数
FROM
dept_emp de
WHERE
de.to_date = '9999-01-01'
GROUP BY
de.dept_no
HAVING
count( de.emp_no ) > 30000
分页查询
客户端通过传递start(页码),limit(每页显示的条数)两个参数去分页查询数据库表中的数据,那我们知道MySql数据库提供了分页的函数limit m,n,但是该函数的用法和我们的需求不一样,所以就需要我们根据实际情况去改写适合我们自己的分页语句
通过上面的分析,可以得出符合我们自己需求的分页sql格式是:select * from table limit (start-1)*limit,limit; 其中start是页码,limit是每页显示的条数
4. 数据库锁
锁分类
从数据库系统角度分为三种:排他锁、共享锁、更新锁。
从程序员角度分为两种:一种是悲观锁,一种乐观锁。
传统的关系数据库里用到了很多这种锁机制,比如行锁、表锁、读锁、写锁等,都是在操作之前先上锁。
悲观锁按使用性质划分
共享锁(Share Lock)
S锁,也叫读锁,用于所有的只读数据操作。共享锁是非独占的,允许多个并发事务读取其锁定的资源。
性质
1. 多个事务可封锁同一个共享页;
2. 任何事务都不能修改该页;
3. 通常是该页被读取完毕,S锁立即被释放。
在SQL Server中,默认情况下,数据被读取后,立即释放共享锁。
例如,执行查询语句“SELECT * FROM my_table”时,首先锁定第一页,读取之后,释放对第一页的锁定,然后锁定第二页。这样,就允许在读操作过程中,修改未被锁定的第一页。
例如,语句“SELECT * FROM my_table HOLDLOCK”就要求在整个查询过程中,保持对表的锁定,直到查询完成才释放锁定。
排他锁(Exclusive Lock)
X锁,也叫写锁,表示对数据进行写操作。如果一个事务对对象加了排他锁,其他事务就不能再给它加任何锁了。(某个顾客把试衣间从里面反锁了,其他顾客想要使用这个试衣间,就只有等待锁从里面打开了。)
性质
1. 仅允许一个事务封锁此页;
2. 其他任何事务必须等到X锁被释放才能对该页进行访问;
3. X锁一直到事务结束才能被释放。
产生排他锁的SQL语句如下:select * from ad_plan for update;
更新锁
U锁,在修改操作的初始化阶段用来锁定可能要被修改的资源,这样可以避免使用共享锁造成的死锁现象
5.索引
索引的优点
大大加快数据的检索速度,这也是创建索引的最主要的原因;
加速表和表之间的连接;
在使用分组和排序子句进行数据检索时,同样可以显著减少查询中分组和排序的时间;
通过创建唯一性索引,可以保证数据库表中每一行数据的唯一性;
索引是对数据库表中一个或多个列的值进行排序的数据结构,以协助快速查询、更新数据库表中数据。索引的实现通常使用B_TREE及其变种。索引加速了数据访问,因为存储引擎不会再去扫描整张表得到需要的数据;相反,它从根节点开始,根节点保存了子节点的指针,存储引擎会根据指针快速寻找数据。
6. Mysql如何为表字段添加索引?
1.添加PRIMARY KEY(主键索引)
ALTER TABLE table_name ADD PRIMARY KEY ( column )
2.添加UNIQUE(唯一索引)
ALTER TABLE table_name ADD UNIQUE ( column )
3.添加INDEX(普通索引)
ALTER TABLE table_name ADD INDEX index_name ( column )
4.添加FULLTEXT(全文索引)
ALTER TABLE table_name ADD FULLTEXT ( column)
5.添加多列索引
ALTER TABLE table_name ADD INDEX index_name ( column1, column2, column3 )
7. 索引的数据结构
如果说数据库表中的数据是一本书,那么索引就是书的目录。索引能够让我们快速的定位想要查询的数据。
索引的结构:BTree 索引和 Hash 索引。
MyISAM 和 InnoDB 存储引擎:只支持 BTREE 索引, 也就是说默认使用 BTREE,不能够更换。
MEMORY/HEAP 存储引擎:支持 HASH 和 BTREE 索引。
索引的分类:单列索引(普通索引,唯一索引,主键索引)、组合索引、全文索引、空间索引
索引:B+,B-,全文索引
Mysql的索引是一个数据结构,旨在使数据库高效的查找数据。
常用的数据结构是B+Tree,每个叶子节点不但存放了索引键的相关信息还增加了指向相邻叶子节点的指针,这样就形成了带有顺序访问指针的B+Tree,做这个优化的目的是提高不同区间访问的性能。
什么时候使用索引:
经常出现在group by,order by和distinc关键字后面的字段
经常与其他表进行连接的表,在连接字段上应该建立索引
经常出现在Where子句中的字段
经常出现用作查询选择的字段
B+数的优势:
评价一个索引好坏主要看IO的访问次数,B+树红黑树来说,树高很小(出度很大)即可以有效降低IO的访问次数。B+数的高度h=logd(n),d越大,h越小,查询效率越高。相对B树,B+树d可以很大,因为非叶子节点不存储数据,只存储key,在一个存储页上可以存储更多的key值。在每个页上可以存储更多的key,即d很大。
外存按照页进行逻辑划分,页大小固定,当读入外存数据时,会根据局部性原理每次会预读连续的多页数据到内存。B+树的叶子节点是存储是连续和有序的,在查询时,尤其在范围查询时较少的IO次数可以访问到所需的数据。
单一节点存储更多的元素,使得查询的IO次数更少。(应用于文件系统、数据库系统)
所有查询都要查找到叶子节点,查询性能稳定。
所有叶子节点形成有序链表,便于范围查询。
通过上面的图我们可以看到,索引的本质其实就是新建了一张表,而表本质上的数据结构就是树形结构,所以索引也是树形结构。但实际运用中并没有谁用红黑树,avl树这种数据结构,一般是b+树,接下来给大家大致介绍一下b+树的构成。
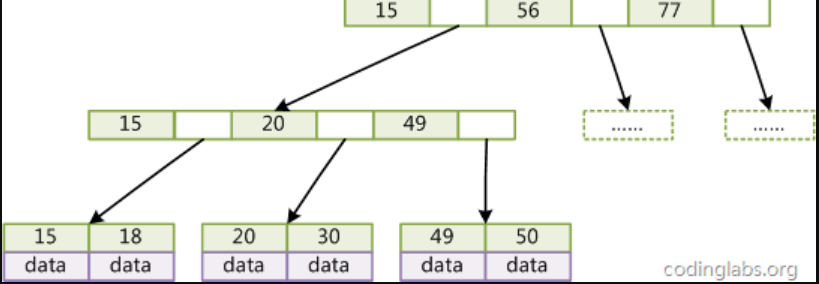
b+树在构建时和我们之前提到的二三树很像,只是有一些改进,b+树的非叶子节点不包含value的信息,也就是说非叶子结点只起到一个导航的作用,所有的value放在了叶子结点里,这样由于B+树在内部节点上不包含数据信息,因此在内存页中能够存放更多的key。 数据存放的更加紧密,具有更好的空间局部性。因此访问叶子节点上关联的数据也具有更好的缓存命中率。通常会将b+树进行优化,增加顺序访问指针。
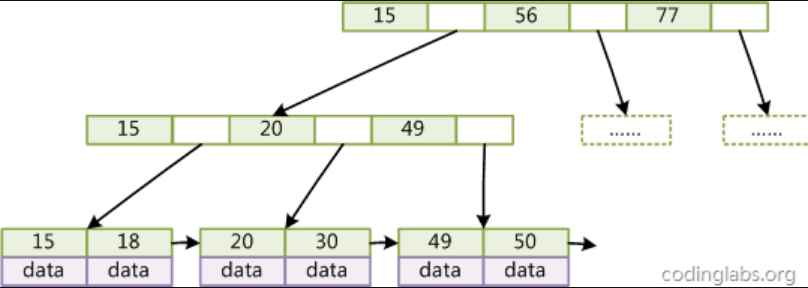
在B+Tree的每个叶子节点增加一个指向相邻叶子节点的指针,就形成了带有顺序访问指针的B+Tree。做这个优化的目的是为了提高区间访问的性能,例如图中如果要查询key为从18到49的所有数据记录,当找到18后,只需顺着节点和指针顺序遍历就可以一次性访问到所有数据节点,极大提到了区间查询
原创不易,完成人机校验,阅读全文