AI相关
共 36 篇已发布文章
RTX 4090 本地跑 MiniMax H3 视频生成:完整技术方案与踩坑总结
RTX4090本地跑MiniMaxH3视频生成:完整技术方案与踩坑总结一、背景MiniMaxH3是目前开源视频生成模型的第一梯队,支持参考图生视频(Ref2VA)、音频驱动、角色一致性等能力。本文基于RTX409024GB+ComfyUI-aki-v3.2的实际生产经验,从模型清单、核心参数、踩坑注意点、优化方案四个维度做完整总结。二、模型清单2.1H3视频生成核心模型(4个)模型文件名大小作用U
爆火 Krea2 才 4.6G!8G 显存跑通风格参考+图生图,影视氛围二创爽翻了
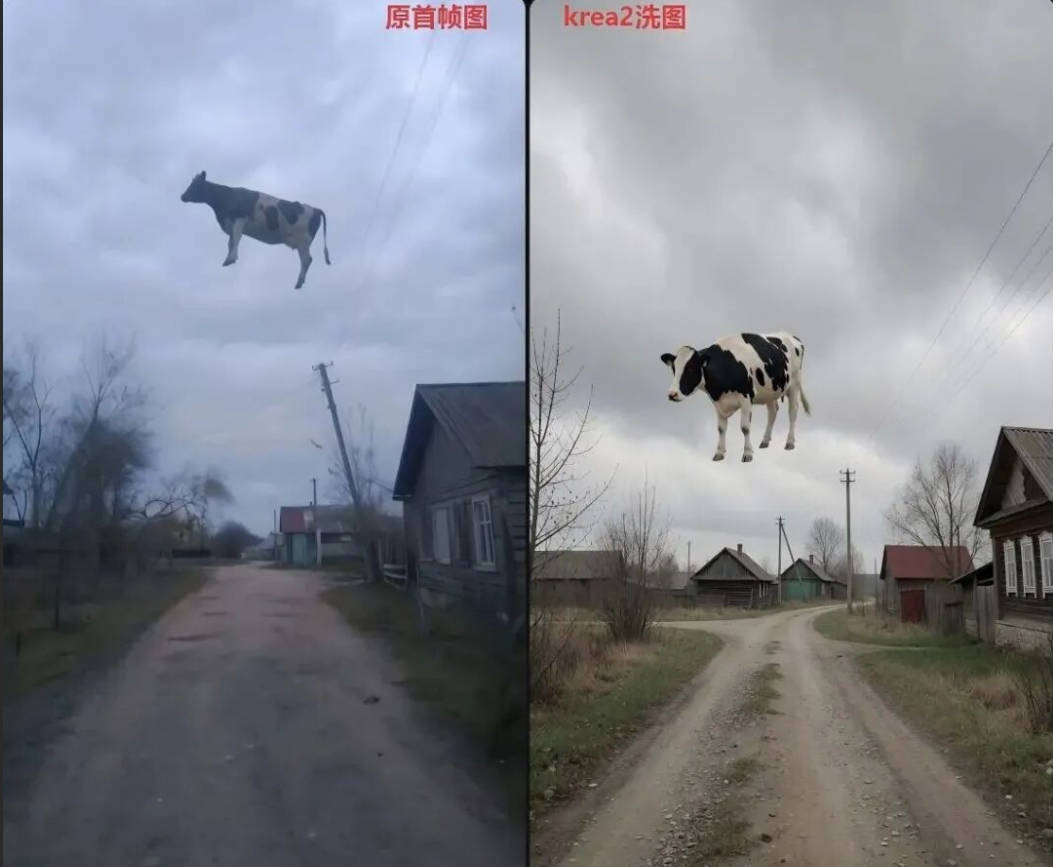
爆火Krea2才4.6G!8G显存跑通风格参考+图生图,影视氛围二创爽翻了原创:凯哥Java本文标签:Krea2量化模型、低显存AI生图、GGUF模型大家好,我是凯哥Java。最近AI圈子有款工具火得一塌糊涂——Krea2。凯哥刷短视频的时候看到一个牛在天上飞的视频,几秒钟播放量几百万。我当时就在想,这种爆款视频的开头是怎么来的?后来一研究,发现很多创作者都在用Krea2做"二创&quo
🖥️ Codex · QQ2007 怀旧皮肤
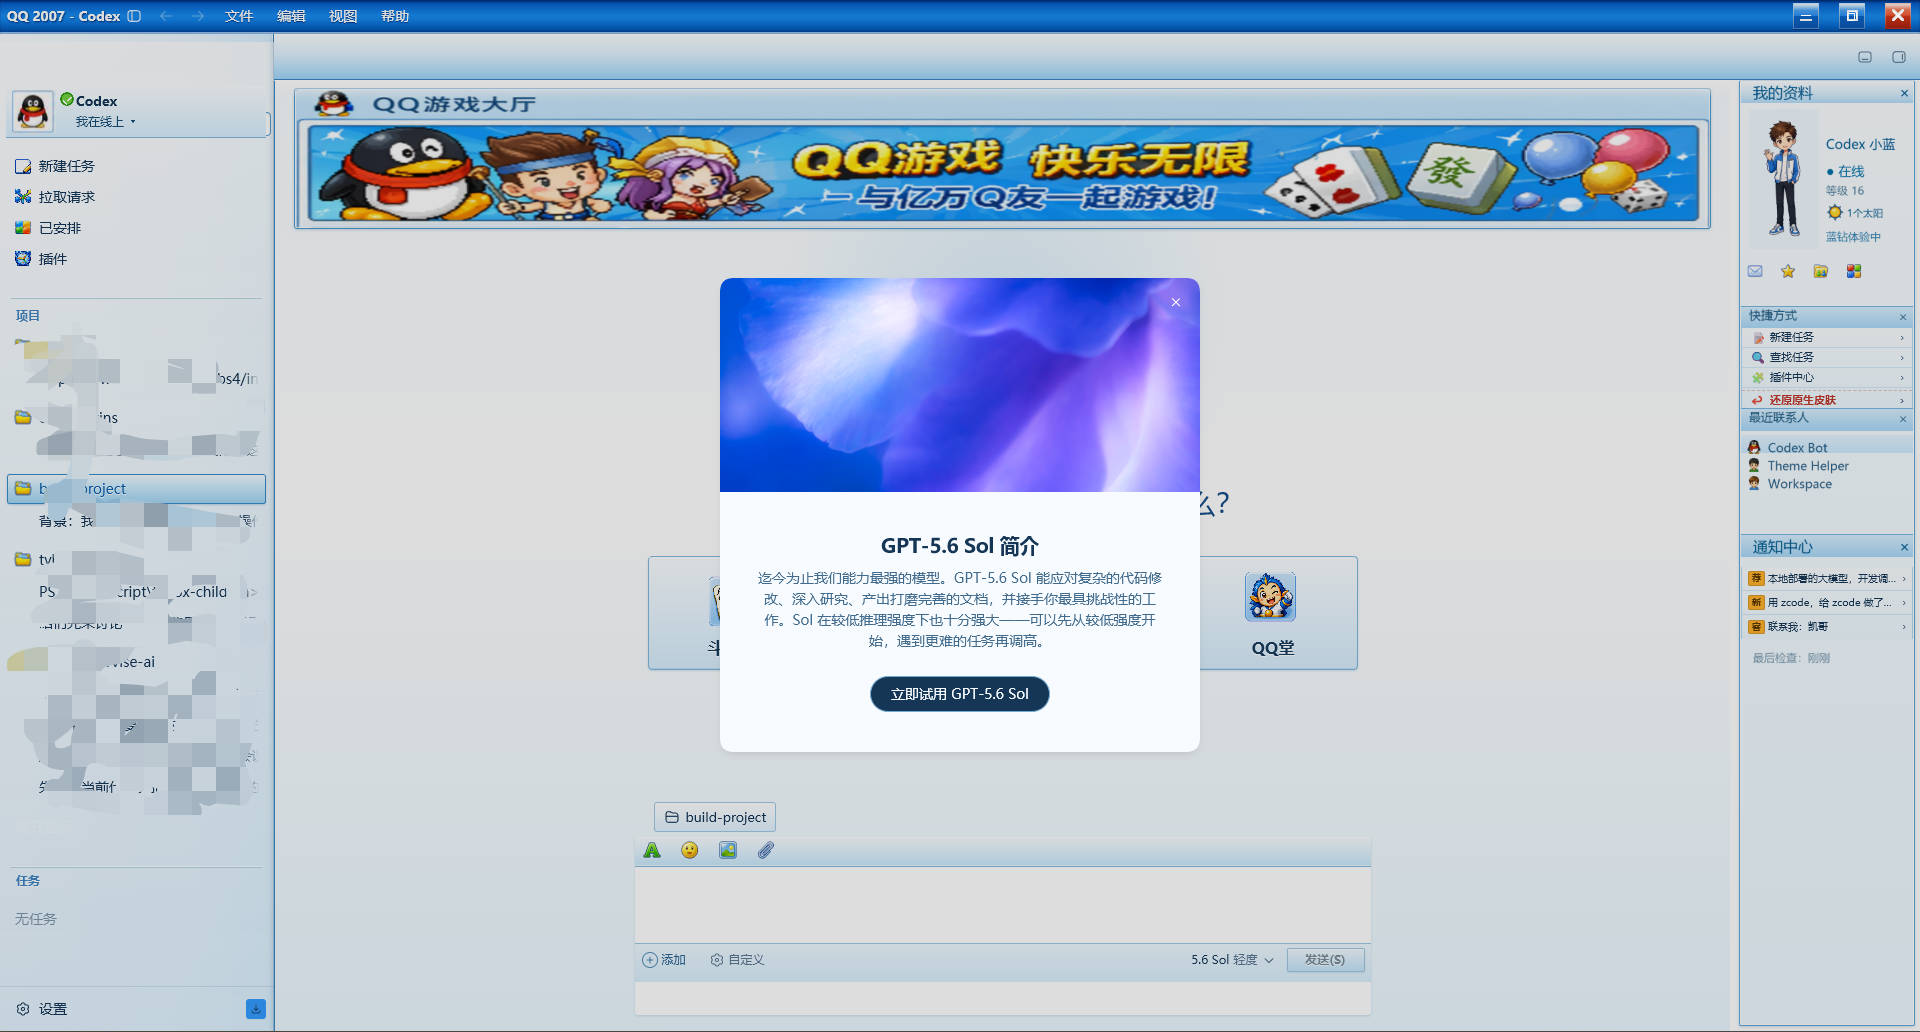
🖥️Codex·QQ2007怀旧皮肤每次打开编辑器,都像回到了2007年那个周六的下午📌这是什么?这是一套Codex桌面编辑器的怀旧皮肤,把编辑器界面换成QQ2007的风格。双击安装,不改你的账号和APIKey,不想要了一键还原。🎨蓝白渐变🪵木质纹理🐧企鹅标题栏🖼️QQ秀展示💬可换头像昵称Codex正常编程,界面是QQ2007✨功能特性左侧QQ经典头像+昵称+签名栏,均可自定义四个左

GPT-5.6强到让白宫睡不着!跑分碾压Fable 5、价格砍半,但全网都买不到
GPT-5.6强到让白宫睡不着!跑分碾压Fable5、价格砍半,但全网都买不到本文标签:OpenAI、GPT-5.6、AI模型、白宫、AI管制文章摘要:OpenAI官宣GPT-5.6系列,一口气三档:旗舰Sol、中端Terra、走量Luna。Sol跑分超ClaudeFable5、价格砍一半,还能拉起多个子智能体。但模型一发布就被白宫按住限量预览,连Altman都别扭:我不喜欢由政府来挑客户。强到让
在windwos 11 操作系统上部署vllmcpp及运行Qwen3.5-9B
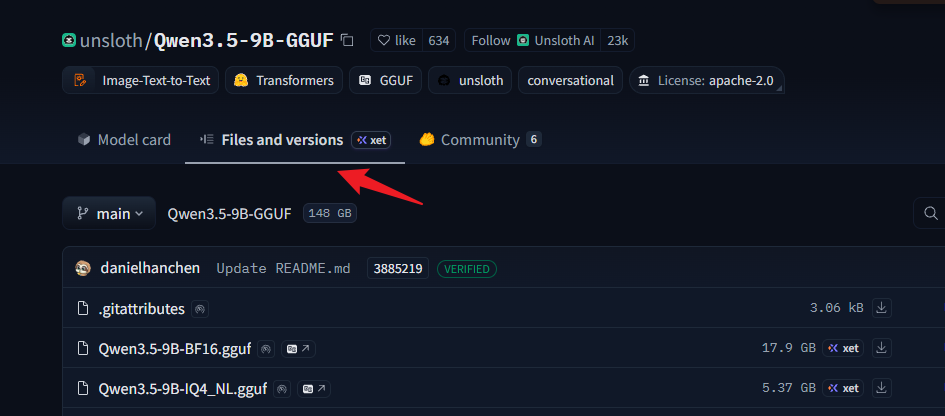
在Windows11上结合你已下载的llama-b9305-bin-win-cuda-13.1-x6(llama.cpp的WindowsCUDA版本)部署该模型,你可以按照以下步骤来下载模型文件并运行:第一步:下载模型文件你需要下载两个文件:主模型文件(.gguf)和多模态视觉投影文件(mmproj...gguf,因为这是一个视觉/多模态模型)。打开浏览器,进入HuggingFace页面:http
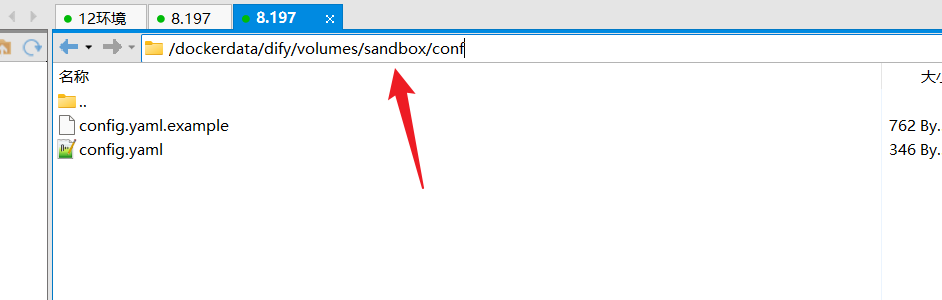
解决dify添加代码节点时候错误信息:Run failed: Failed to execute code, which is likely a network issue, please check if the sandbox service is running. ( Error: [Errno -2] Name or service not known )
问题描述:这是我的dify中配置chatflow的DSL,疑问:当我不配置代码节点的时候,预览输入:未佩戴安全帽就可以正常回复。但是有了代码执行节点之后,同样预览输入同样问题,就错误:Runfailed:Failedtoexecutecode,whichislikelyanetworkissue,pleasecheckifthesandboxserviceisrunning.(Error:[Err
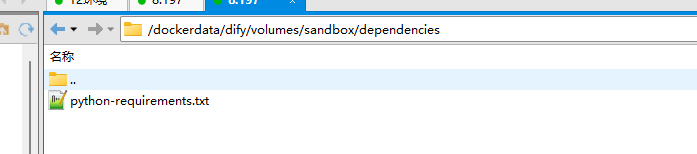
docker中安装dify只使用代码节点错误问题解决2: [ERROR]failed to setup runner dependencies: open dependencies/python-requirements.txt: no such file or directory
问题描述:这是我的dify中配置chatflow的DSL,疑问:当我不配置代码节点的时候,预览输入:未佩戴安全帽就可以正常回复。但是有了代码执行节点之后,同样预览输入同样问题,就错误:Runfailed:Failedtoexecutecode,whichislikelyanetworkissue,pleasecheckifthesandboxserviceisrunning.(Error:[Err
和AI讨论方案技巧:
介绍和AI讨论方案技巧在多次和AI讨论后我的问题:根据上面给出的这个方案,能满足我所有的问题吗?以及我现在解析一个作业票(一版不会超过10页)的,能够控制在3分钟内解析完成吗?我需要的不仅仅是方案,还要可用,稳定。不能说,我丢一个作业票后,半小时才给出风险。这就不行了。在继续分析后,在给出一版完整的详细的解决方案。AI回答:针对你提出的“10页作业票能否控制在3分钟内”以及“系统可用性和稳定性”的
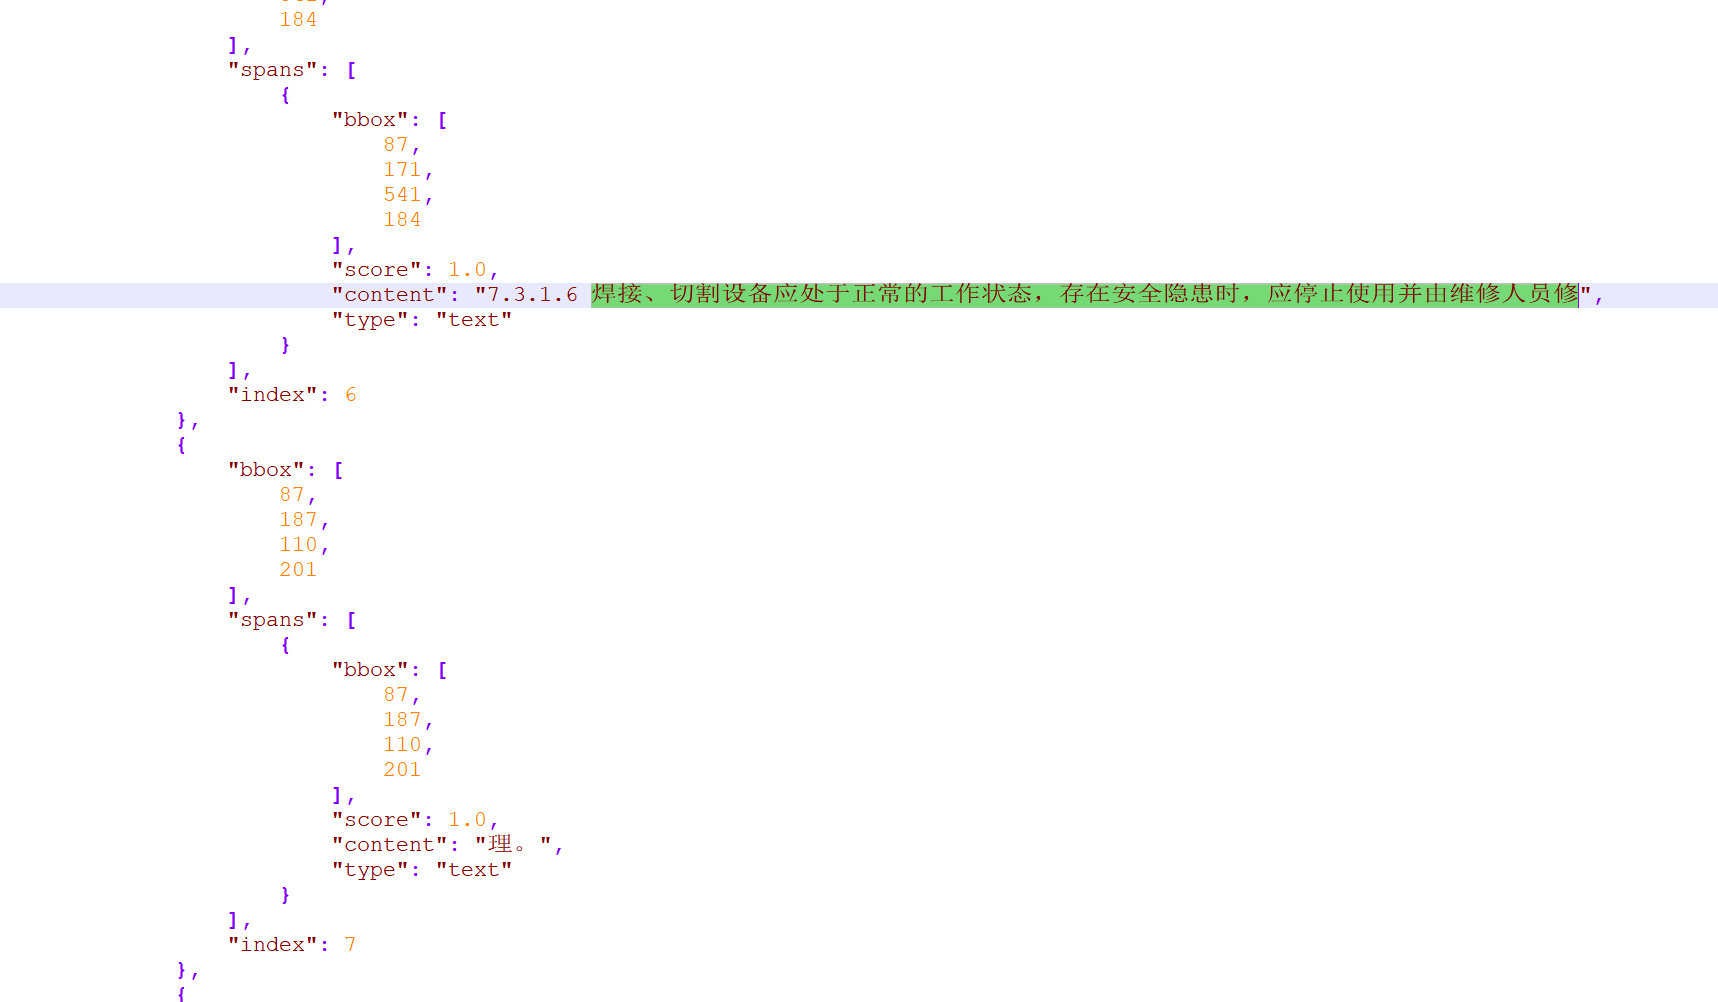
minerU中间数据处理一些疑问:
minerU中间数据结构:官网https://opendatalab.github.io/MinerU/reference/output_files/#intermediate-processing-results-middlejson 实际: 问题2(长句跨行被拆分):这是一个Line级别的问题。长句“...维修人员修理。”在PDF物理排版上跨越了两行,因此被MinerU解析
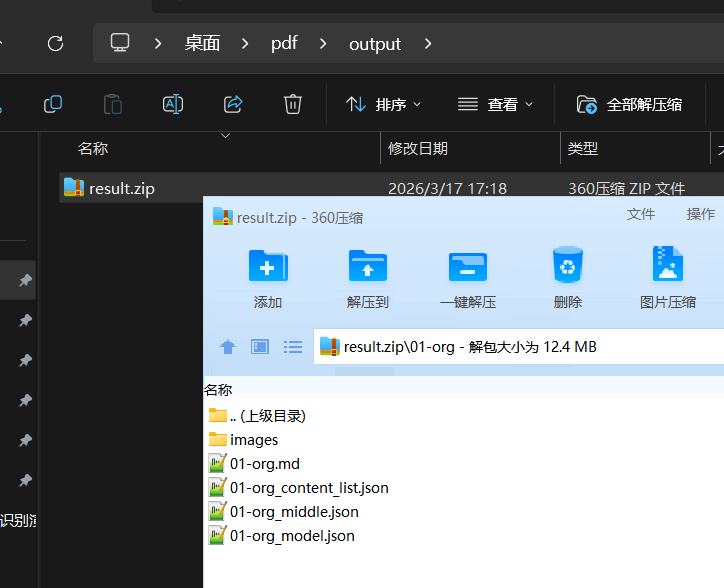
本地部署了minerU,然后java调用后获取到中间产物:
cn.hutool.core.io.FileUtil;cn.hutool.http.HttpRequest;cn.hutool.http.HttpResponse;com.fasterxml.jackson.databind.JsonNode;com.fasterxml.jackson.databind.ObjectMapper;java.io.File;java.util.HashMap;jav
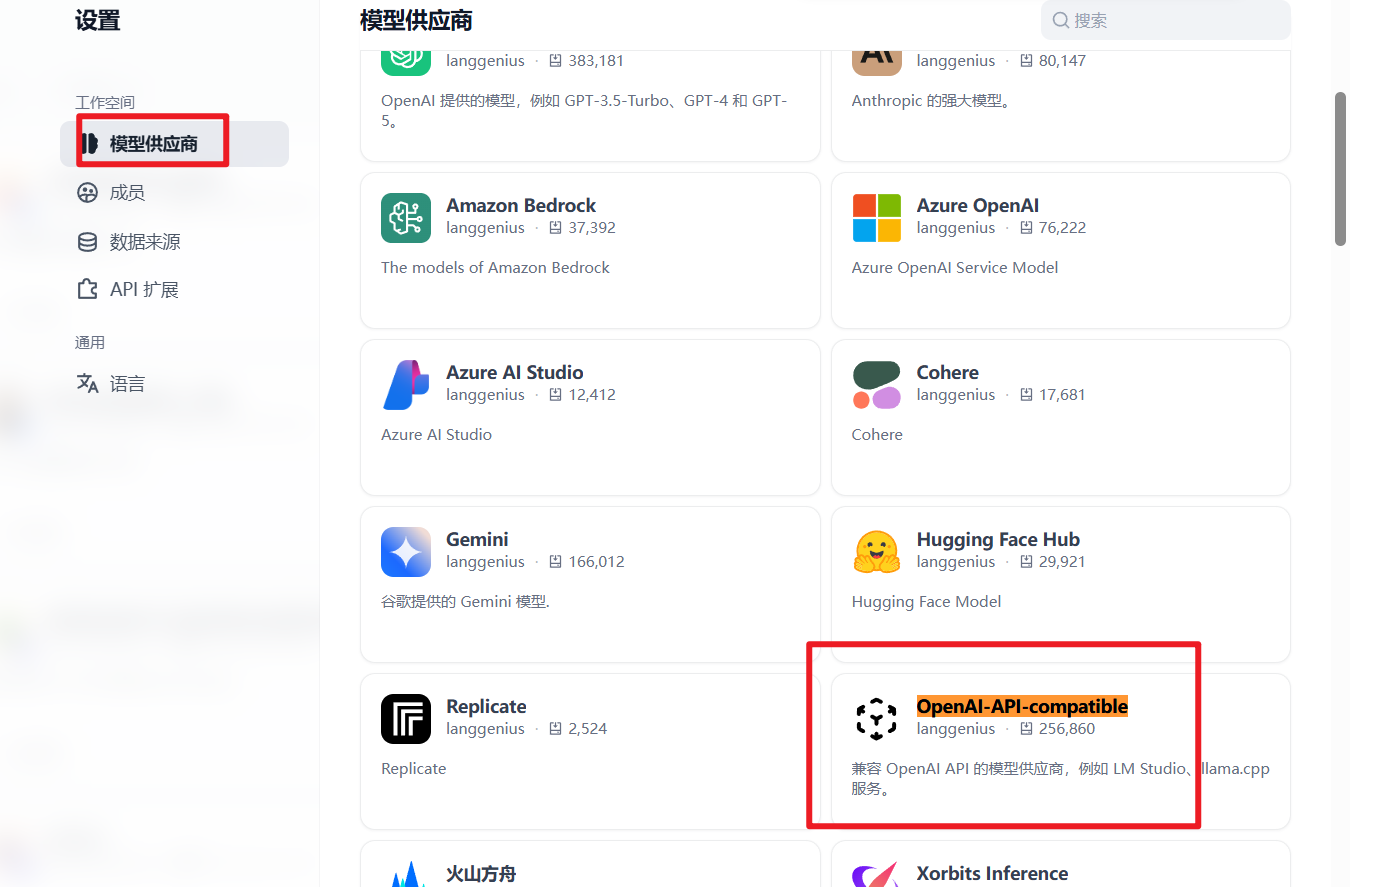
手把手教你,怎么在dify中配置自定义的模型
背景描述:因为本地部署了qwen3-vi:latest。想要在dify中使用,我们知道ollama类型的是不支持qwen3-vi:latest。所以,这里就得用到添加自定义模型了。具体操作步骤如下:在Dify中添加自定义模型主要有两种方式:一是通过内置的兼容供应商通道(如“OpenAI-API-compatible”或“Ollama”)快速接入;二是通过Dify的后端配置实现更深度的自定义,适合私
设计模仿DeepSeek网页版的前端用户交互接口之疑问二
在设计模仿DeepSeek网页版的前端用户交互接口文章中疑问:创建新会话接口、发送新问题(生成基础回答)接口 这俩接口入参就只有chatId这个字段区别吗?如果我chatId是有前端页面创建的,那么这两个接口是不是没区别了?
设计模仿DeepSeek网页版的前端用户交互接口之疑问一
在设计模仿DeepSeek网页版的前端用户交互接口文章中疑问:创建新会话接口、发送新问题(生成基础回答)接口、重新生成回答 。这三个接口什么关系? 创建新会话接口是新建会话页面中发送的第一个问题吗? 发送新问题(生成基础回答)接口是在一个会话页面中,多次问答吗? 重新生成回答接口是一个问题,多轮回答吗?
设计模仿DeepSeek网页版的前端用户交互接口
需求:需要结合“会话内多次问答+单问题多轮回答(版本)+重新生成+点赞点踩”的完整需求,设计模仿DeepSeek网页版的前端用户交互接口。以下是覆盖所有核心场景的接口设计,包含接口功能、参数、响应及业务逻辑说明:一、前端用户交互核心接口(按模块分类)1.应用模块(选择AI应用)接口功能请求方式请求URL请求参数(示例)响应示例获取应用列表GET/api/ai/application/listpag

Dify集成MinerU插件解析PDF失败排查
我在本地docker安装了minerU,在dify中也集成了minerU插件。但是测试pdf解析,返回:Failedtoparsefile.result:{"detail":"NotFound"}你在Dify中测试MinerU插件时遇到 {"detail":"NotFound"} 错误,这通常是因为

dify工作流带有文件上传接口的使用
在docker中部署了dify,想要直接使用dify的API上传图片,怎么操作?一、先把docker中dify的API暴露出来。使用dockerps命令查看可以看到我暴露出来的端口是5001.二、创建工作流比如我的pdf解析工作流如下:创建完成之后,点击发布应用。发布完成查看API:点击访问API然后跳转到新页面,在新页面的右上角,有API密钥。点击此按钮,会有弹窗:在这个弹窗里面,可以新建或者查

AI文档服务设计
在AI问答服务中,设计到新创建问答、问答历史、一个文档中多轮提问、一轮提问中又有多轮回答,然后还可以重新生成、点赞、踩等操作。这个时候表怎么设计呢?一、表关系总览(层级+关联字段)四张表的关联可通过**“主从层级+核心关联字段”**梳理,整体关系链为:ai_application_chat(会话) → ai_application_chat_record(问答记录/版本)&nb
关于AI一些思考
针对不同场景,可以先使用小模型进行识别然后用来路由到大模型。比如先识别图片有没有人,有人了之后,在看有没有安全帽,然后路由到对应大模型;正对文档类型的比如PDF或者word等文档,处理:先要使用小模型对版式分割,在分割完成之后,根据内容进行大模型处理。关于AI精确度问题:先给出初版,运行后误报,人工介入反馈,调校模型,从而是模型达到更高精度;关于灵活性:支持对不同场景,自己训练模型。根据训练出模型
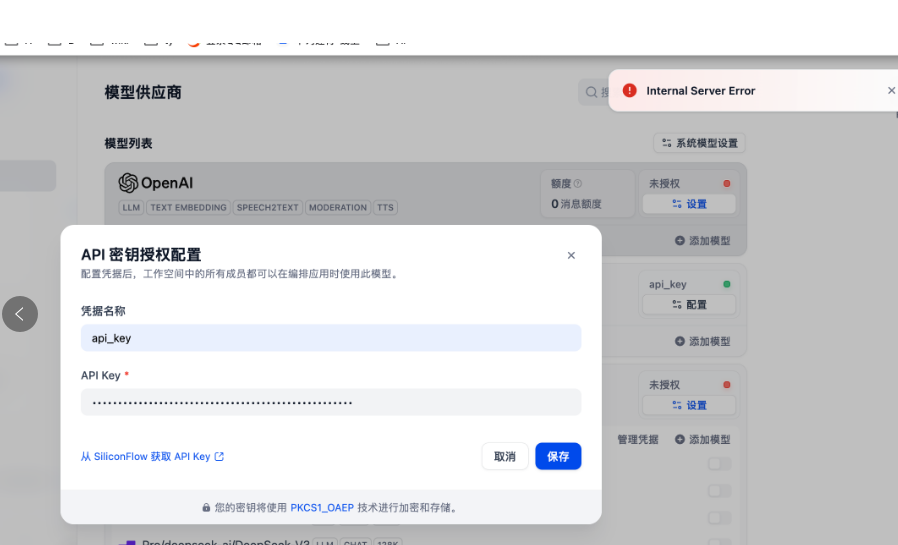
本地docker部署Dify之后,在添加硅基流动,提示错误:Internal Server Erro! 解决方案
本地在docker搭建了dify之后,想要添加硅基流动的。在设置,添加模型,选择硅基流动。然后添加硅基流动的apikey,错误提示如下图:解决方案:可以添加单个模型。怎么添加呢?去硅基流动官网,点击模型广场按钮。如下图:比如我要添加Qwen/Qwen3-Next-80B-A3B-Instruct。点击对应模型回到dify的模型配置页面。找到硅基流动,点击添加模型在弹出页面,输入对应信息。点击添加,
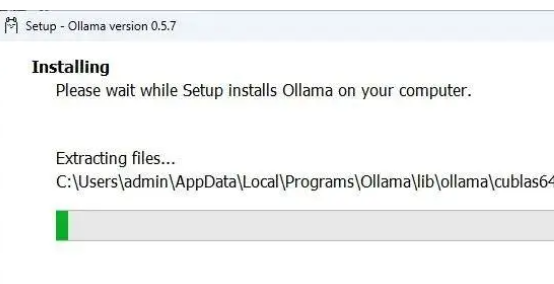
ollama默认安装到C盘怎么修改
下载好安装包之后若直接打开默认装在C盘admin,比如:如果想要修改,可以通过下述操作更改安装位置。实操如下:我的OllamaSetup.exe在F:\temp中,后面f:\PraticalTools\ollama是我更改后的安装路.执行命令:比如凯哥的ollamaSetup.exe在:C:\Users\Administrator\Downloads\OllamaSetup.exe想要把ollam