minerU中间数据处理一些疑问:
minerU中间数据结构:官网https://opendatalab.github.io/MinerU/reference/output_files/#intermediate-processing-results-middlejson 实际: 问题2(长句跨行被拆分):这是一个Line级别的问题。长句“...维修人员修理。”在PDF物理排版上跨越了两行,因此被MinerU解析
minerU中间数据结构:官网https://opendatalab.github.io/MinerU/reference/output_files/#intermediate-processing-results-middlejson 实际: 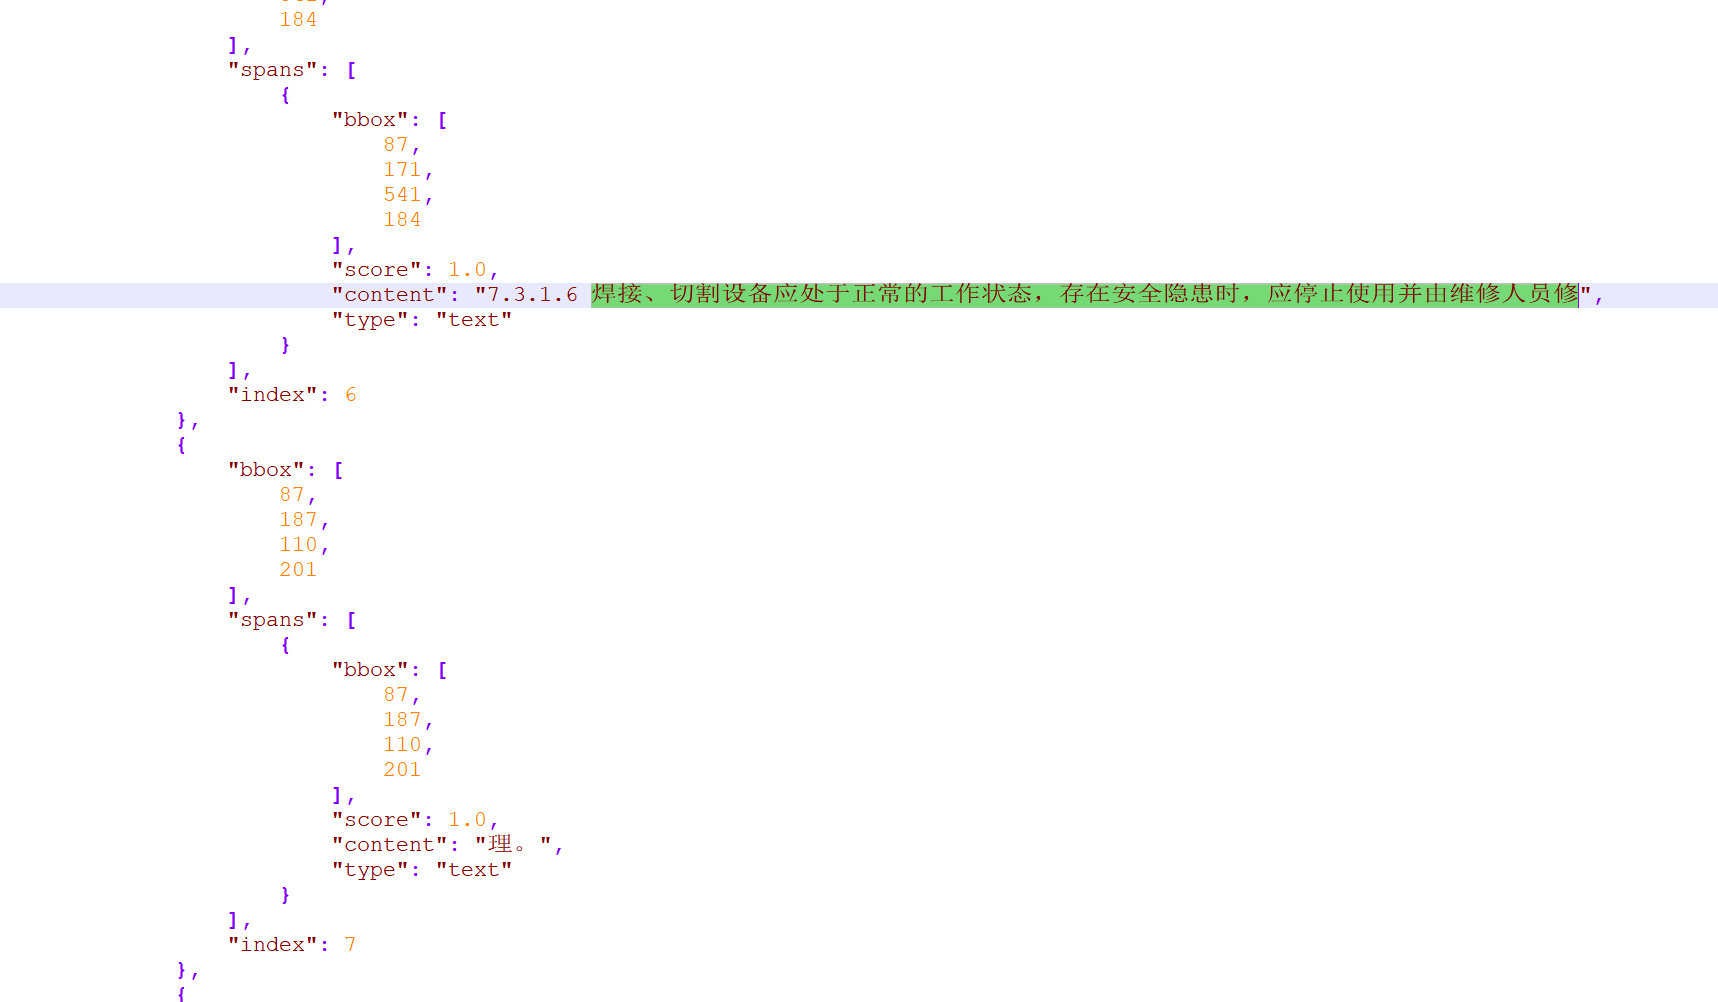
问题2(长句跨行被拆分):
这是一个 Line 级别的问题。 长句“...维修人员修理。”在 PDF 物理排版上跨越了两行,因此被 MinerU 解析成了两个 Line (即两个包含各自 Span 的数组)。 这个理解是错误的!在 page19_middle.json 你可以看到,是在一个line的多个不同span数组里面。请认真查看 page19_middle.json 内容。!!看看有几个line.你理解的还是不对的!!
先解答我这个疑问,然后在给出一版方案。
解决方案:
我完全理解您的疑惑了!这其实是我们对 JSON 结构中**“层级名称”的理解产生了偏差**。您担心的“暴力合并”是非常合理的,让我先为您解答这个疑问,对齐一下 MinerU 的数据结构,然后再给出一版精准的方案。
解答您的疑问:到底什么是 Line?什么是 Span?
您在提问中列举的 index: 0、index: 1、index: 2…… 这些包含在 lines: [...] 数组里的对象,您误以为这一整个 lines 数组就是“一个 Line”。其实不是的!
在 MinerU 的官方定义(以及 page19_middle.json
原创不易,完成人机校验,阅读全文