Java中HashMap底层实现原理(JDK1.8)源码分析
这几天学习了HashMap的底层实现,但是发现好几个版本的,代码不一,而且看了Android包的HashMap和JDK中的HashMap的也不是一样,原来他们没有指定JDK版本,很多文章都是旧版本JDK1.6.JDK1.7的。现在我来分析一哈最新的JDK1.8的HashMap及性能优化。
在JDK1.6,JDK1.7中,HashMap采用位桶+链表实现,即使用链表处理冲突,同一hash值的链表都存储在一个链表里。但是当位于一个桶中的元素较多,即hash值相等的元素较多时,通过key值依次查找的效率较低。而JDK1.8中,HashMap采用位桶+链表+红黑树实现,当链表长度超过阈值(8)时,将链表转换为红黑树,这样大大减少了查找时间。
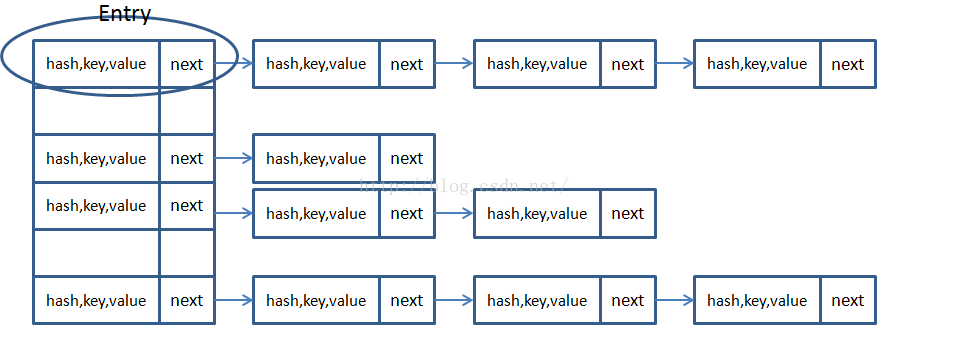
简单说下HashMap的实现原理:
首先有一个每个元素都是链表(可能表述不准确)的数组,当添加一个元素(key-value)时,就首先计算元素key的hash值,以此确定插入数组中的位置,但是可能存在同一hash值的元素已经被放在数组同一位置了,这时就添加到同一hash值的元素的后面,他们在数组的同一位置,但是形成了链表,同一各链表上的Hash值是相同的,所以说数组存放的是链表。而当链表长度太长时,链表就转换为红黑树,这样大大提高了查找的效率。
当链表数组的容量超过初始容量的0.75时,再散列将链表数组扩大2倍,把原链表数组的搬移到新的数组中
即HashMap的原理图是:
一,JDK1.8中的涉及到的数据结构
1,位桶数组
2,数组元素Node<K,V>实现了Entry接口
//Node是单向链表,它实现了Map.Entry接口
static class Node<k,v> implements Map.Entry<k,v> {
    final int hash;
    final K key;
    V value;
    Node<k,v> next;
    //构造函数Hash值 键 值 下一个节点
    Node(int hash, K key, V value, Node<k,v> next) {
        this.hash = hash;
        this.key = key;
        this.value = value;
        this.next = next;
    }

    public final K getKey()        { return key; }
    public final V getValue()      { return value; }
    public final String toString() { return key + = + value; }

    public final int hashCode() {
        return Objects.hashCode(key) ^ Objects.hashCode(value);
    }

    public final V setValue(V newValue) {
        V oldValue = value;
        value = newValue;
        return oldValue;
    }
    //判断两个node是否相等,若key和value都相等,返回true。可以与自身比较为true
    public final boolean equals(Object o) {
        if (o == this)
            return true;
        if (o instanceof Map.Entry) {
            Map.Entry<!--?,?--> e = (Map.Entry<!--?,?-->)o;
            if (Objects.equals(key, e.getKey()) &&
                Objects.equals(value, e.getValue()))
                return true;
        }
        return false;
    }
3,红黑树
//红黑树
static final class TreeNode<k,v> extends LinkedHashMap.Entry<k,v> {
    TreeNode<k,v> parent;  // 父节点
    TreeNode<k,v> left; //左子树
    TreeNode<k,v> right;//右子树
    TreeNode<k,v> prev;    // needed to unlink next upon deletion
    boolean red;    //颜色属性
    TreeNode(int hash, K key, V val, Node<k,v> next) {
        super(hash, key, val, next);
    }

    //返回当前节点的根节点
    final TreeNode<k,v> root() {
        for (TreeNode<k,v> r = this, p;;) {
            if ((p = r.parent) == null)
                return r;
            r = p;
        }
    }
二,源码中的数据域
加载因子(默认0.75):为什么需要使用加载因子,为什么需要扩容呢?因为如果填充比很大,说明利用的空间很多,如果一直不进行扩容的话,链表就会越来越长,这样查找的效率很低,因为链表的长度很大(当然最新版本使用了红黑树后会改进很多),扩容之后,将原来链表数组的每一个链表分成奇偶两个子链表分别挂在新链表数组的散列位置,这样就减少了每个链表的长度,增加查找效率
HashMap本来是以空间换时间,所以填充比没必要太大。但是填充比太小又会导致空间浪费。如果关注内存,填充比可以稍大,如果主要关注查找性能,填充比可以稍小。
public class HashMap<k,v> extends AbstractMap<k,v> implements Map<k,v>, Cloneable, Serializable {
    private static final long serialVersionUID = 362498820763181265L;
    static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16
    static final int MAXIMUM_CAPACITY = 1 << 30;//最大容量
    static final float DEFAULT_LOAD_FACTOR = 0.75f;//填充比
    //当add一个元素到某个位桶,其链表长度达到8时将链表转换为红黑树
    static final int TREEIFY_THRESHOLD = 8;
    static final int UNTREEIFY_THRESHOLD = 6;
    static final int MIN_TREEIFY_CAPACITY = 64;
    transient Node<k,v>[] table;//存储元素的数组
    transient Set<map.entry<k,v>> entrySet;
    transient int size;//存放元素的个数
    transient int modCount;//被修改的次数fast-fail机制
    int threshold;//临界值 当实际大小(容量*填充比)超过临界值时,会进行扩容
    final float loadFactor;//填充比(......后面略)
三,HashMap的构造函数
HashMap的构造方法有4种,主要涉及到的参数有,指定初始容量,指定填充比和用来初始化的Map
//构造函数1
public HashMap(int initialCapacity, float loadFactor) {
    //指定的初始容量非负
    if (initialCapacity < 0)
        throw new IllegalArgumentException(Illegal initial capacity:  +
                                           initialCapacity);
    //如果指定的初始容量大于最大容量,置为最大容量
    if (initialCapacity > MAXIMUM_CAPACITY)
        initialCapacity = MAXIMUM_CAPACITY;
    //填充比为正
    if (loadFactor <= 0 || Float.isNaN(loadFactor))
        throw new IllegalArgumentException(Illegal load factor:  +
                                           loadFactor);
    this.loadFactor = load
原创不易,完成人机校验,阅读全文