Redis的Hash结构大数据量拆分成多个小的hash工具类
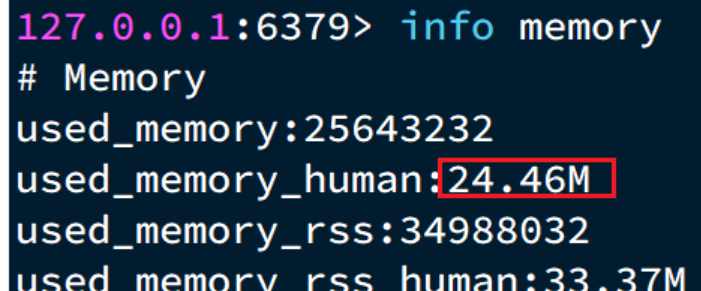
假如有hash类型的key,其中有100万对field和value,field是自增id,这个key存在什么问题?如何优化?拆分前占用内存大小:方案:拆分为小的hash,将id/100作为key,将id%100作为field,这样每100个元素为一个Hash拆分后,占用内存大小:拆分工具类:import com.heima.jedis.util.JedisConnectionFactor
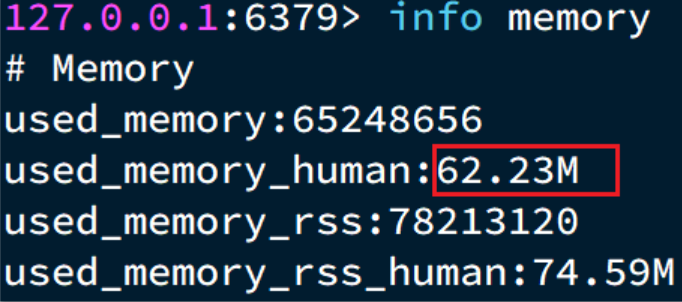
方案:
拆分为小的hash,将 id / 100 作为key, 将id % 100 作为field,这样每100个元素为一个Hash
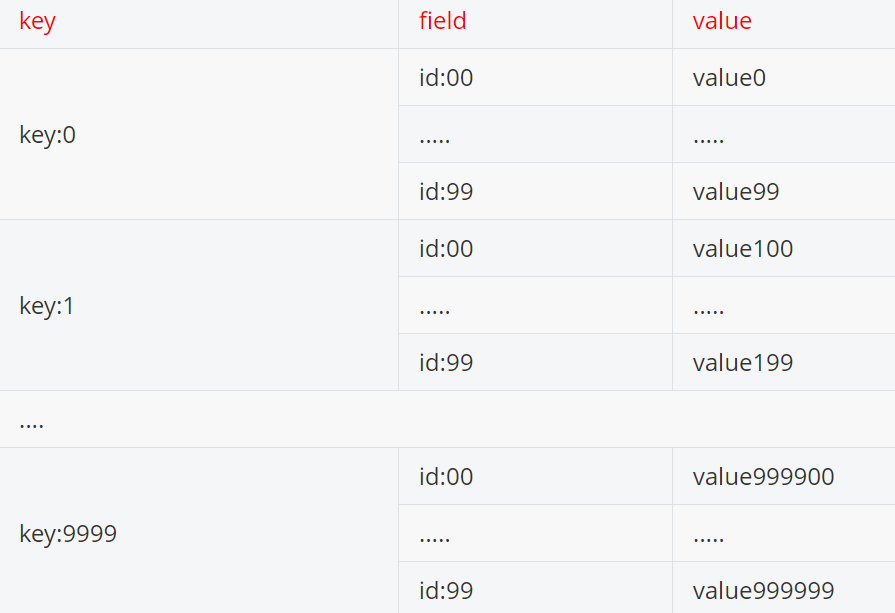
拆分后,占用内存大小:
拆分工具类:
import com.heima.jedis.util.JedisConnectionFactory;
        import org.junit.jupiter.api.AfterEach;
        import org.junit.jupiter.api.BeforeEach;
        import org.junit.jupiter.api.Test;
        import redis.clients.jedis.Jedis;
        import redis.clients.jedis.Pipeline;
        import redis.clients.jedis.ScanResult;

        import java.util.HashMap;
        import java.util.List;
        import java.util.Map;

public class JedisTest {
原创不易,完成人机校验,阅读全文