460道Java后端面试高频题答案版【模块二:Java集合类】
写在前面个人觉得Java集合类在面试过程中是个超高频的模块,所以一定要认真准备每个知识点。那么我个人学习这块知识点的方法是:1、阅读源码:这一块的考点可以说就是看你对有没有阅读过集合类的源码以及对其的掌握程度。因为在平时的开发中几乎每天都在和集合类打交道,只有了解清楚它们底层的实现原理,才能在日常业务开发中选择合适的集合。可能会有人说阅读源码比较枯燥,看不下去,但是Java集合类的源码真的还好,并
写在前面
3、看大佬们的源码分析文章:因为你看的可是 JDK 的源码,其中很多设计精妙之处不是“我等菜鸡”随便就可以看出来的,所以多看看大佬们的文章,肯定会有意外的收获;4、看面经:这个也是少不了的,了解面试官们问问题的方式和频率,可以有优先级的准备。
常见容器主要包括 Collection 和 Map 两种,Collection 存储着对象的集合,而 Map 存储着键值对(两个对象)的映射表。
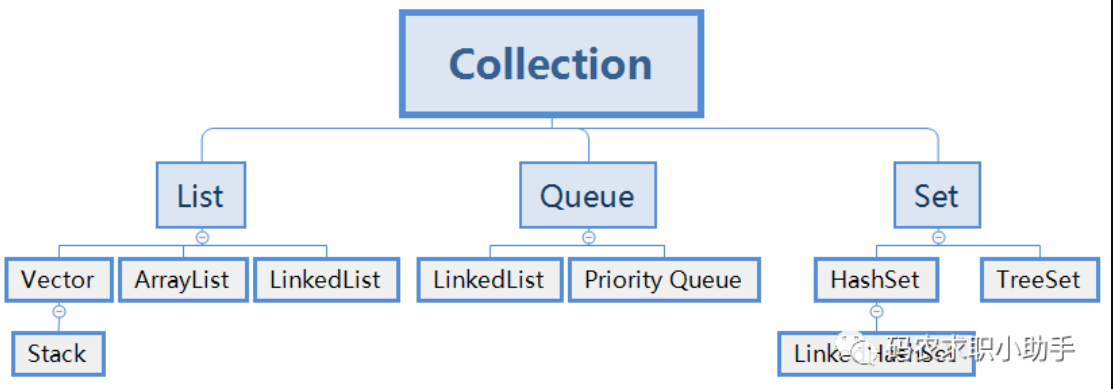
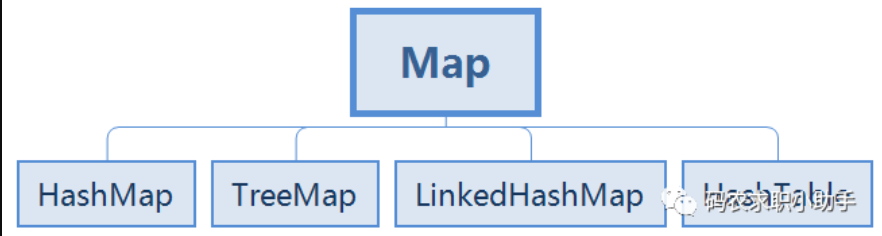
Collection
Set
1、TreeSet:基于红黑树实现,支持有序性操作,例如:根据一个范围查找元素的操作。但是查找效率不如 HashSet,HashSet 查找的时间复杂度为 O(1),TreeSet 则为 O(logN)。
2、HashSet:基于哈希表实现,支持快速查找,但不支持有序性操作。并且失去了元素的插入顺序信息,也就是说使用 Iterator 遍历 HashSet 得到的结果是不确定的。
3、LinkedHashSet:具有 HashSet 的查找效率,且内部使用双向链表维护元素的插入顺序。
- List
3、LinkedList:基于双向链表实现,只能顺序访问,但是可以快速地在链表中间插入和删除元素。不仅如此,LinkedList 还可以用作栈、队列和双向队列。
Queue
Map
2、ArrayList 和 LinkedList 的区别?
ArrayList:底层是基于数组实现的,查找快,增删较慢;2. 如果删除操作的位置是在中间。由于 LinkedList 的消耗主要是在遍历上,ArrayList 的消耗主要是在移动和复制上(底层调用的是 arrayCopy() 方法,是 native 方法)。LinkedList 的遍历速度是要慢于 ArrayList 的复制移动速度的如果数据量有百万级的时,还是 ArrayList 要快。
3、ArrayList 实现 RandomAccess 接口有何作用?为何 LinkedList 却没实现这个接口?
1. RandomAccess 接口只是一个标志接口,只要 List 集合实现这个接口,就能支持快速随机访问。通过查看 Collections 类中的 binarySearch() 方法,可以看出,判断 List 是否实现 RandomAccess 接口来实行indexedBinarySerach(list, key) 或 iteratorBinarySerach(list, key)方法。再通过查看这两个方法的源码发现:实现 RandomAccess 接口的 List 集合采用一般的 for 循环遍历,而未实现这接口则采用迭代器,即 ArrayList 一般采用 for 循环遍历,而 LinkedList 一般采用迭代器遍历;推荐阅读:
https://juejin.im/post/5d42ab5e5188255d691bc8d6
- 当使用 add 方法的时候首先调用 ensureCapacityInternal 方法,传入 size+1 进去,检查是否需要扩充 elementData 数组的大小;
- newCapacity = 扩充数组为原来的 1.5 倍(不能自定义),如果还不够,就使用它指定要扩充的大小 minCapacity ,然后判断 minCapacity 是否大于 MAX_ARRAY_SIZE(Integer.MAX_VALUE - 8) ,如果大于,就取 Integer.MAX_VALUE;
- 扩容的主要方法:grow;
- ArrayList 中 copy 数组的核心就是 System.arraycopy 方法,将 original 数组的所有数据复制到 copy 数组中,这是一个本地方法。
Array 可以容纳基本类型和对象,而 ArrayList 只能容纳对象;
Array 是指定大小的,而 ArrayList 大小是固定的。
如果列表的大小已经指定,大部分情况下是存储和遍历它们;
对于遍历基本数据类型,尽管 Collections 使用自动装箱来减轻编码任务,
原创不易,完成人机校验,阅读全文