【凯哥强烈推荐】头条二面: 详解一条 SQL 的执行过程
前言
天天和数据库打交道,一天能写上几十条 SQL 语句,但你知道我们的系统是如何和数据库交互的吗?MySQL 如何帮我们存储数据、又是如何帮我们管理事务?....是不是感觉真的除了写几个 「select * from dual」外基本脑子一片空白?这篇文章就将带你走进 MySQL 的世界,让你彻底了解系统到底是如何和 MySQL 交互的,MySQL 在接受到我们发送的 SQL 语句时又分别做了哪些事情。
MySQL 驱动
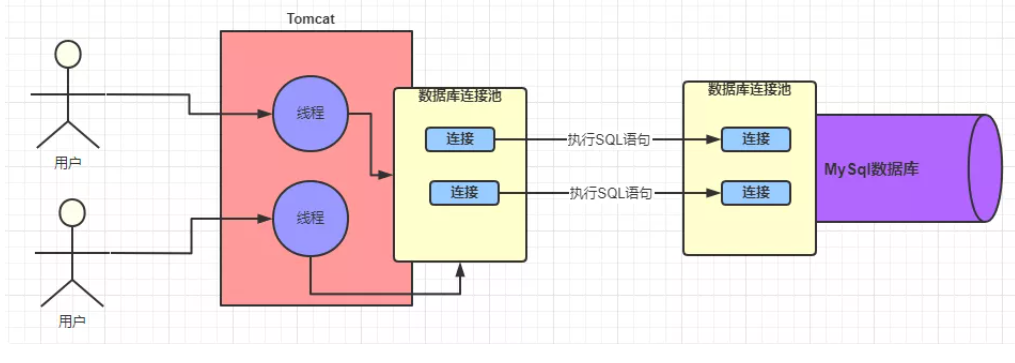
我们的系统在和 MySQL 数据库进行通信的时候,总不可能是平白无故的就能接收和发送请求,就算是你没有做什么操作,那总该是有其他的“人”帮我们做了一些事情,基本上使用过 MySQL 数据库的程序员多多少少都会知道 MySQL 驱动这个概念的。就是这个 MySQL 驱动在底层帮我们做了对数据库的连接,只有建立了连接了,才能够有后面的交互。看下图表示
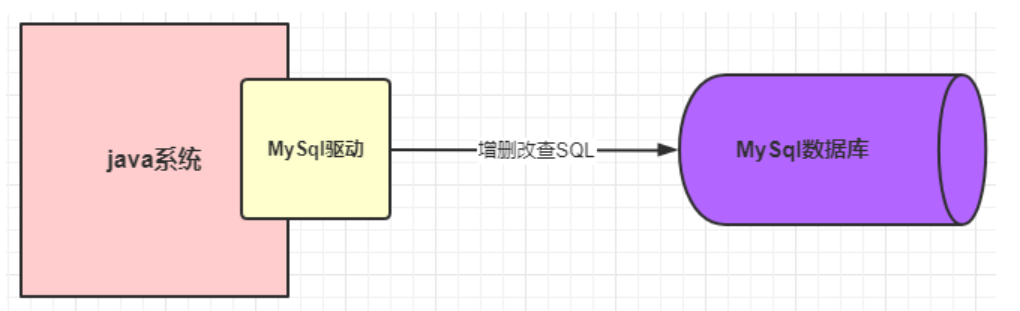
这样的话,在系统和 MySQL 进行交互之前,MySQL 驱动会帮我们建立好连接,然后我们只需要发送 SQL 语句就可以执行 CRUD 了。一次 SQL 请求就会建立一个连接,多个请求就会建立多个连接,那么问题来了,我们系统肯定不是一个人在使用的,换句话说肯定是存在多个请求同时去争抢连接的情况。我们的 web 系统一般都是部署在 tomcat 容器中的,而 tomcat 是可以并发处理多个请求的,这就会导致多个请求会去建立多个连接,然后使用完再都去关闭,这样会有什么问题呢?如下图:
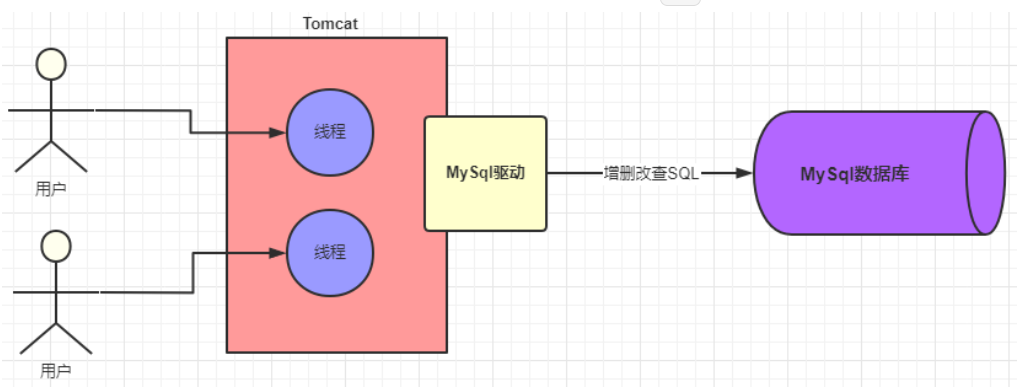
java 系统在通过 MySQL 驱动和 MySQL 数据库连接的时候是基于 TCP/IP 协议的,所以如果每个请求都是新建连接和销毁连接,那这样势必会造成不必要的浪费和性能的下降,也就说上面的多线程请求的时候频繁的创建和销毁连接显然是不合理的。必然会大大降低我们系统的性能,但是如果给你提供一些固定的用来连接的线程,这样是不是不需要反复的创建和销毁连接了呢?相信懂行的朋友会会心一笑,没错,说的就是数据库连接池。
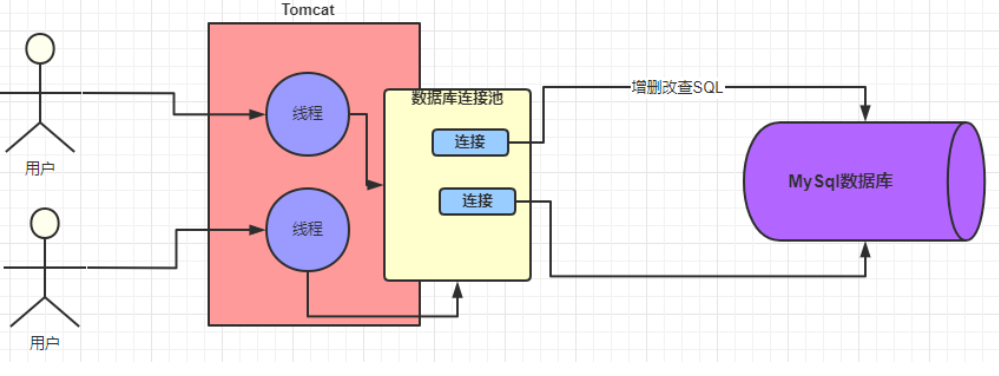
常见的数据库连接池有 Druid、C3P0、DBCP,连接池实现原理在这里就不深入讨论了,采用连接池大大节省了不断创建与销毁线程的开销,这就是有名的「池化」思想,不管是线程池还是 HTTP 连接池,都能看到它的身影。
数据库连接池
到这里,我们已经知道的是我们的系统在访问 MySQL 数据库的时候,建立的连接并不是每次请求都会去创建的,而是从数据库连接池中去获取,这样就解决了因为反复的创建和销毁连接而带来的性能损耗问题了。不过这里有个小问题,业务系统是并发的,而 MySQL 接受请求的线程呢,只有一个?
其实 MySQL 的架构体系中也已经提供了这样的一个池子,也是数据库连池。双方都是通过数据库连接池来管理各个连接的,这样一方面线程之前不需要是争抢连接,更重要的是不需要反复的创建的销毁连接。
至此系统和 MySQL 数据库之间的连接问题已经说明清楚了。那么 MySQL 数据库中的这些连接是怎么来处理的,又是谁来处理呢?
网络连接必须由线程来处理
对计算基础稍微有一点了解的的同学都是知道的,网络中的连接都是由线程来处理的,所谓网络连接说白了就是一次请求,每次请求都会有相应的线程去处理的。也就是说对于 SQL 语句的请求在 MySQL 中是由一个个的线程去处理的。
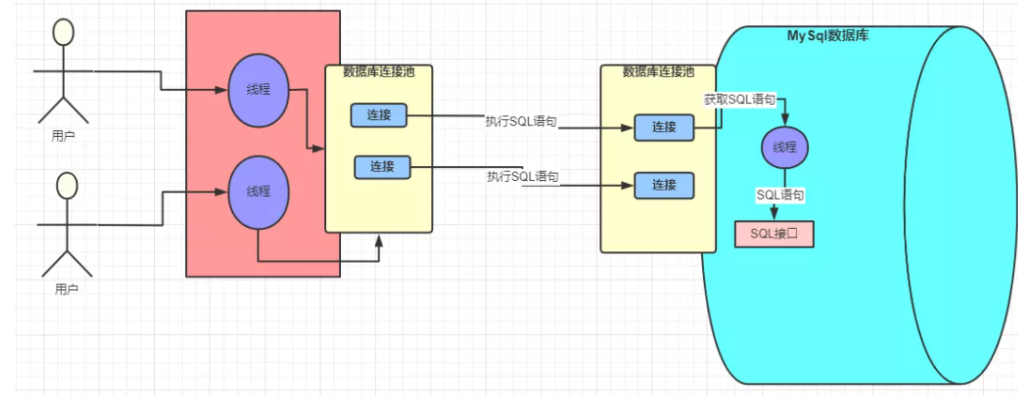
那这些线程会怎么去处理这些请求?会做哪些事情?
SQL 接口
MySQL 中处理请求的线程在获取到请求以后获取 SQL 语句去交给 SQL 接口去处理。
查询解析器
假如现在有这样的一个 SQL:
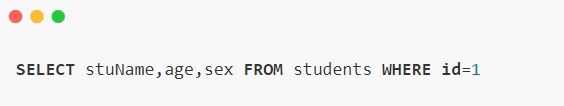
但是这个 SQL 是写给我们人看的,机器哪里知道你在说什么?这个时候解析器就上场了。他会将 SQL 接口传递过来的 SQL 语句进行解析,翻译成 MySQL 自己能认识的语言,至于怎么解析的就不需要在深究了,无非是自己一套相关的规则。
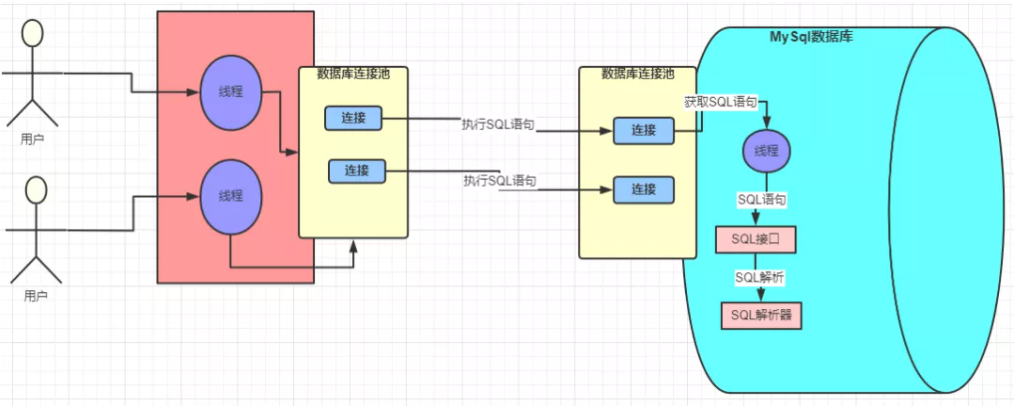 现在 SQL 已经被解析成 MySQL 认识的样子的,那下一步是不是就是执行吗?理论上是这样子的,但是 MySQL 的强大远不止于此,他还会帮我们选择最优的查询路径。

具体是怎么做到的呢?这就要说到 MySQL 的查询优化器了
MySQL 查询优化器
查询优化器内部具体怎么实现的我们不需要是关心,我需要知道的是 MySQL 会帮我去使用他自己认为的最好的方式去优化这条 SQL 语句,并生成一条条的执行计划,比如你创建了多个索引,MySQL 会依据成本最小原则来选择使用对应的索引,这里的成本主要包括两个方面, IO 成本和 CPU 成本
IO 成本: 即从磁盘把数据加载到内存的成本,默认情况下,读取数据页的 IO 成本是 1,MySQL 是以页的形式读取数据的,即当用到某个数据时,并不会只读取这个数据,而会把这个数据相邻的数据也一起读到内存中,这就是有名的程序局部性原理,所以 MySQL 每次会读取一整页,一页的成本就是 1。所以 IO 的成本主要和页的大小有关
CPU 成本:将数据读入内存后,还要检测数据是否满足条件和排序等 CPU 操作的成本,显然它与行数有关,默认情况下,检测记录的成本是 0.2。
MySQL 优化器 会计算 「IO 成本 + CPU」 成本最小的那个索引来执行
画外音:索引成本具体怎么计算,请参考?这篇文章
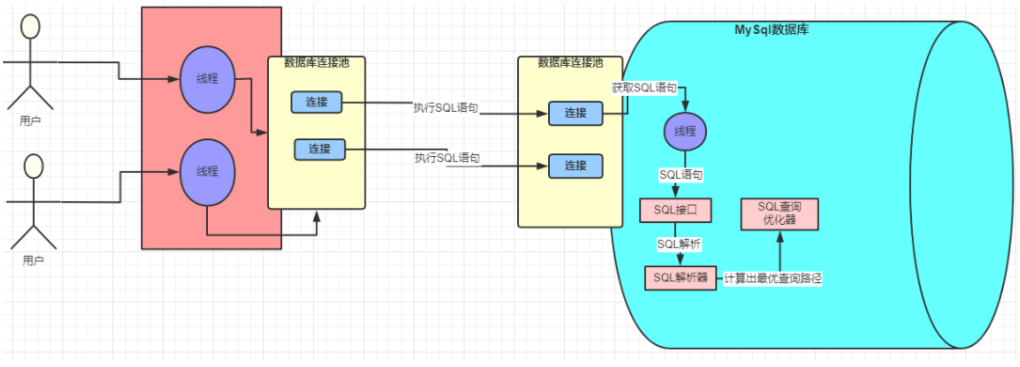
优化器执行选出最优索引等步骤后,会去调用存储引擎接口,开始去执行被 MySQL 解析过和优化过的 SQL 语句
存储引擎
查询优化器会调用存储引擎的接口,去执行 SQL,也就是说真正执行 SQL 的动作是在存储引擎中完成的。数据是被存放在内存或者是磁盘中的(存储引擎是一个非常重要的组件,后面会详细介绍)
本篇文章大家先对存储引擎有一个大致的认识就可以了。后续专门文章来详细介绍的。
执行器
执行器是一个非常重要的组件,因为前面那些组件的操作最终必须通过执行器去调用存储引擎接口才能被执行。执行器最终最根据一系列的执行计划去调用存储引擎的接口去完成 SQL 的执行
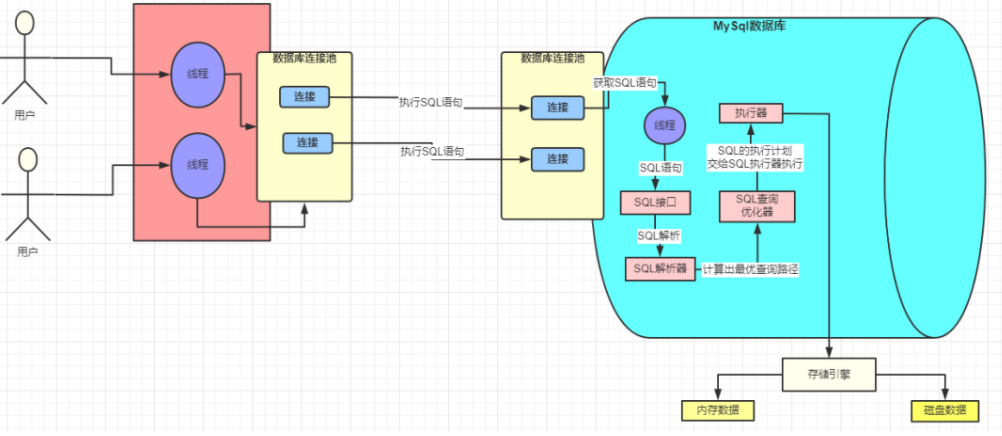
初识存储引擎
我们以一个更新的SQL语句来说明,SQL 如下
UPDATE students SET stuName = '小强' WHERE id = 1
当我们系统发出这样的查询去交给 My
原创不易,完成人机校验,阅读全文