Mysql 索引精讲
开门见山,直接上图,下面的思维导图即是现在要讲的内容,可以先有个印象~
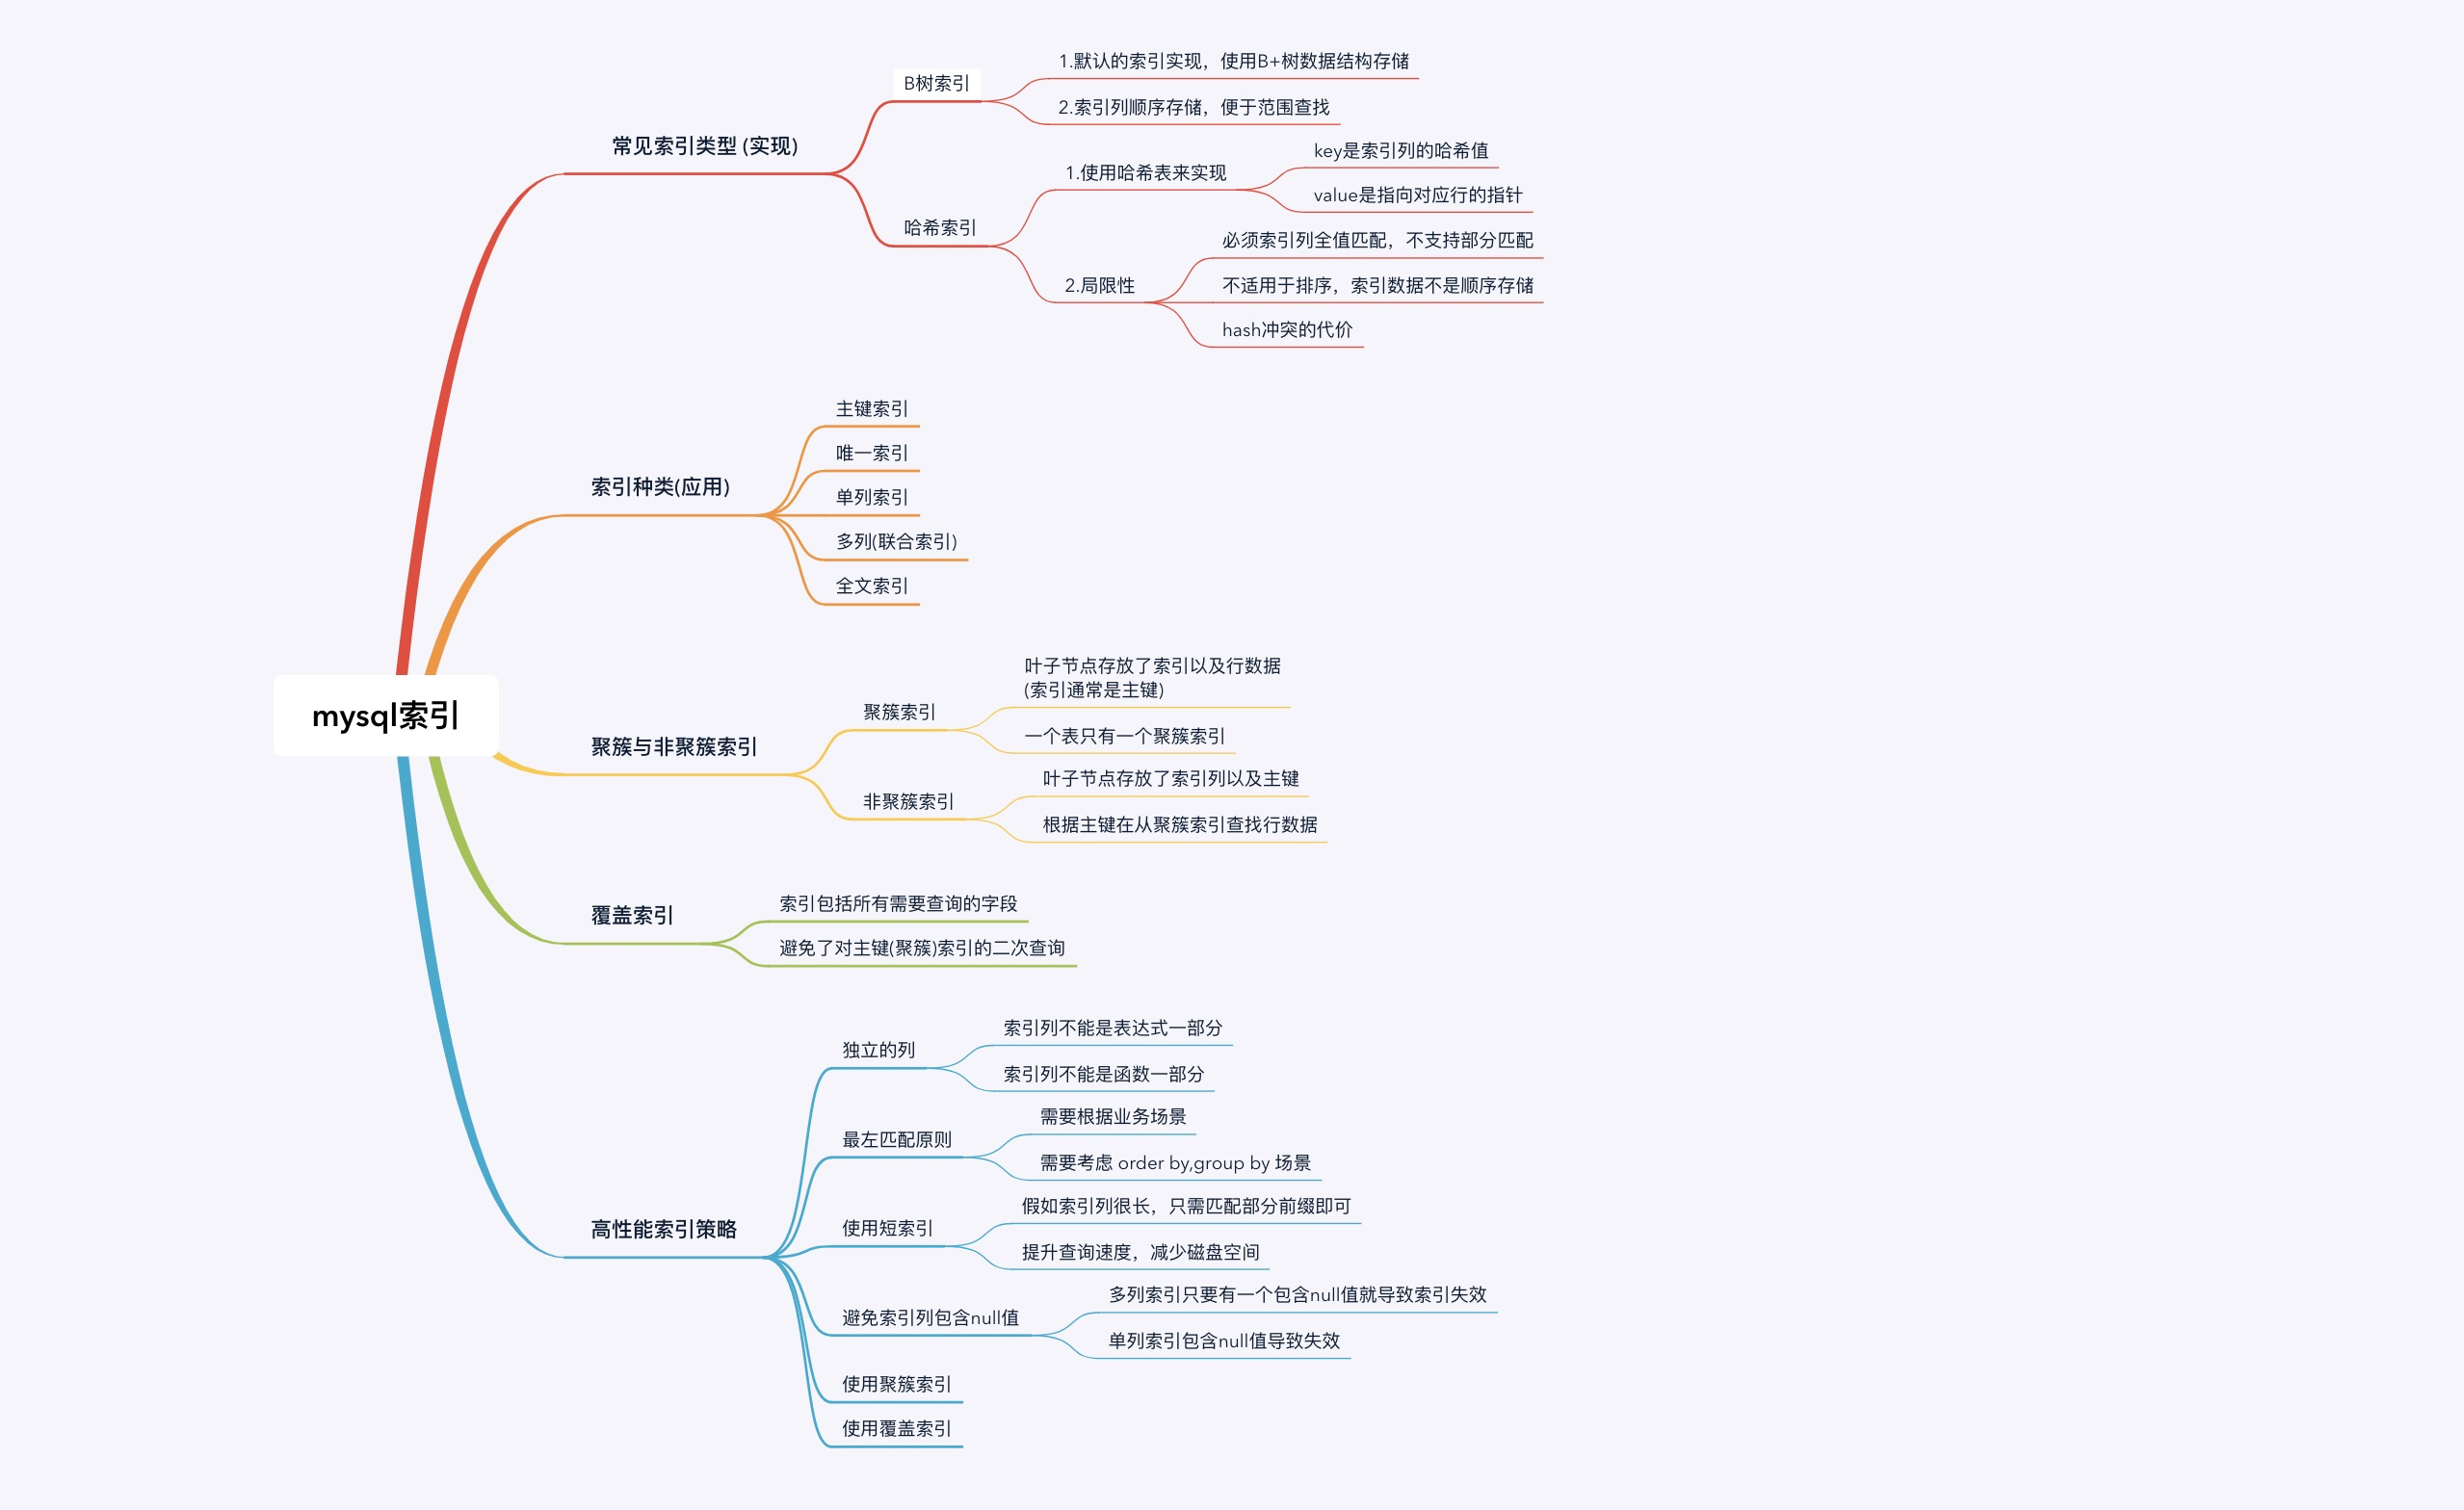
常见索引类型(实现层面)
索引种类(应用层面)
聚簇索引与非聚簇索引
覆盖索引
最佳索引使用策略
1.常见索引类型(实现层面)
首先不谈Mysql怎么实现索引的,先马后炮一下,如果让我们来设计数据库的索引,该怎么设计?
我们首先思考一下索引到底想达到什么效果?其实就是想能够实现快速查找数据的策略,所以索引的实现本质上就是一个查找算法。
但是跟普通的查找有所不同,因为我们的数据有一下特征:
1.存储的数据是非常非常多的
2.并且还不断的动态变化
所以实现索引时需要考虑到这两个特点。我们需要找一个最合适的数据结构算法来实现查找功能。
下面一起看下常见的查找策略,如下图:
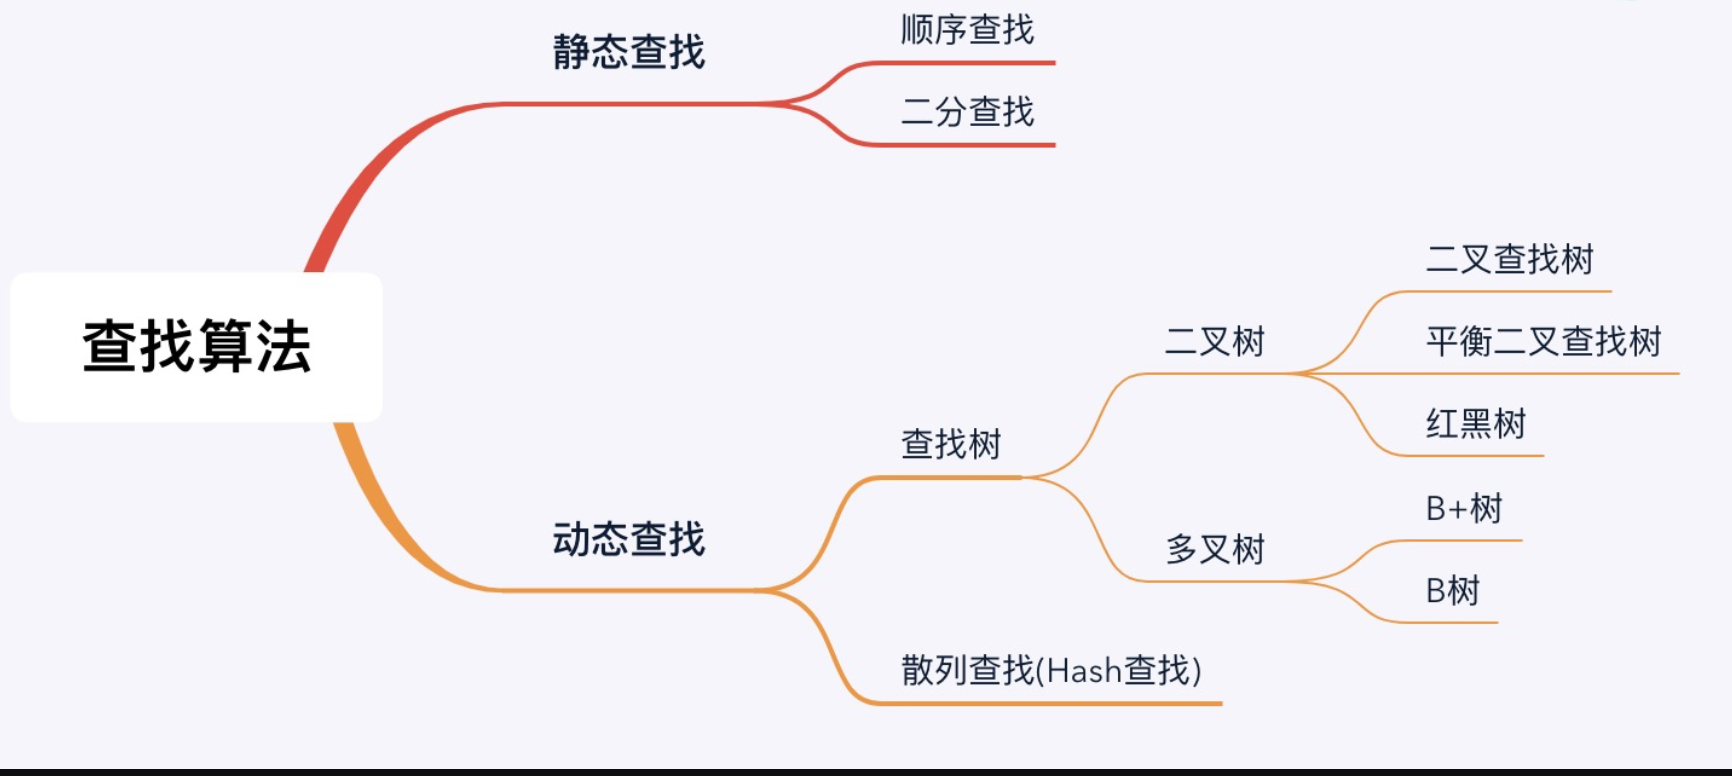
由于前面说的两个特点我们首先排除静态查找的算法。
至于查找树,我们有二叉树和多叉树两种选择:
二叉树:如果先泽二叉树的话,由于我们的数据量庞大,二叉树的深度会变得非常大,我们的索引树会变成参天大树,每次查询会导致很多磁盘IO。
多叉树:多叉树解决了了树的深度大的问题,那么我们到底选择B树还是B+树呢?
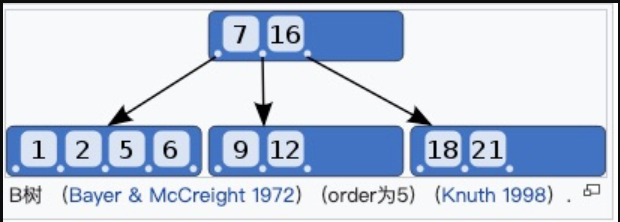
B树 摘自维基百科 https://zh.wikipedia.org/wiki/B%2B树
B+树 摘自维基百科 https://zh.wikipedia.org/wiki/B%2B树
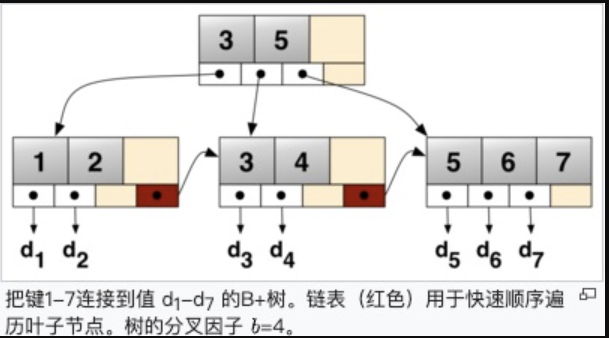
从上面图可知B+树的叶子节点存放了所有的索引值,并且叶子结点之间以链表的形式相互关联,所以我们只需从最左的链表遍历的话即可查找所有的值,最常见的用途就是范围查找,而B树则不满足这范围查找,又或者说实现特别复杂,所以Mysql最终选择了使用B+树实现这一功能。
1.1 B-Tree 索引(B+树)
先说明一下,虽然叫在Mysql官方叫做B-Tree索引,但采用的是B+树数据结构。
B-tree索引能够加快访问数据的速度,不需要进行全表扫描,而是从索引树的根节点层层往下搜索,在根节点存放了索引值和指向下一个节点的指针。
下面看下单列索引的数据怎么组织的。
create table User(`name` varchar(50) not null,`uid` int(4) not null,`gender` int(2) not null, key(`uid`)
);
上面User 表给uid列创建了一个索引,那么往表里插入uid(96~102)的时候存储引擎是怎么管理索引的呢?看下面的索引树
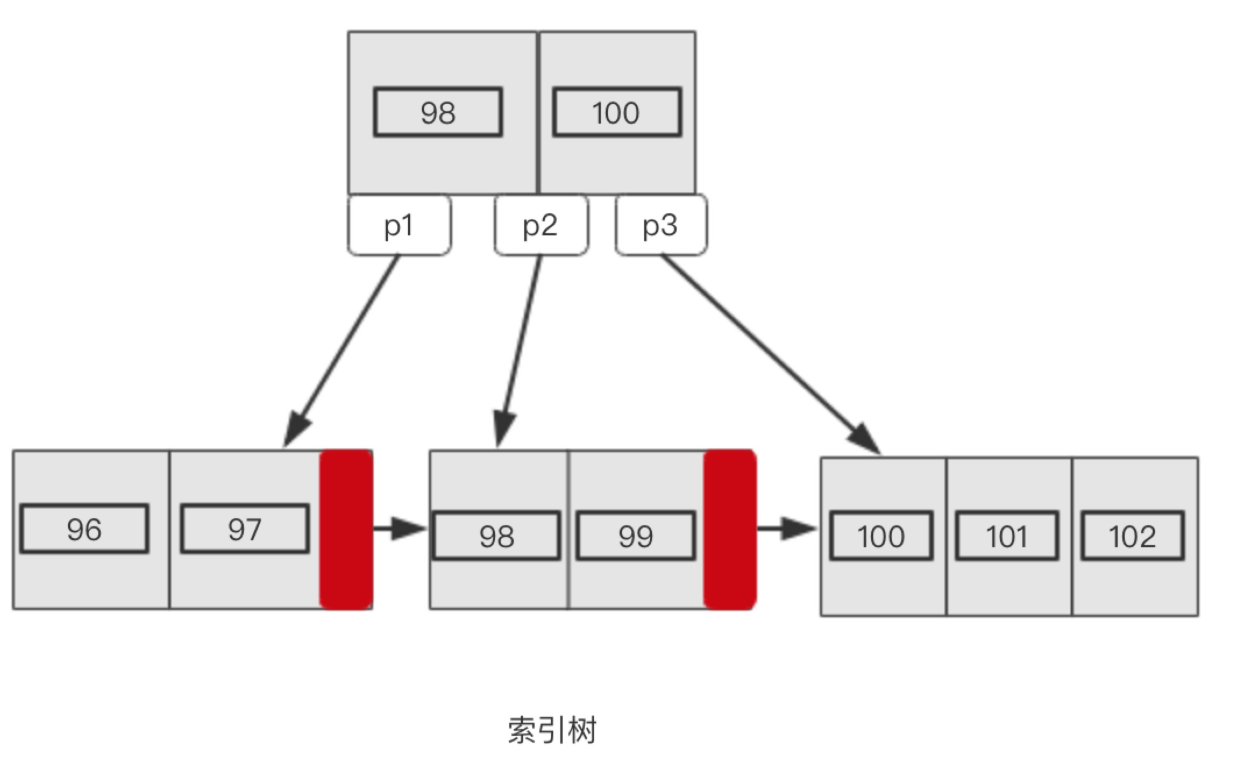
1.在叶子节点存放所有的索引值,非叶子节点值是为了更快定位包含目标值的叶子节点
2.叶子节点的值是有序的
3.叶子节点之间以链表形式关联
下面在看一下多列(联合)索引的数据怎么组织的。
create table User(`name` varchar(50) not null,`uid` int(4) not null,`gender` int(2) not null, key(`uid`,`name`)
);
给User 表创建了联合索引 key(uid,name) 这种情况下他的索引树是如下图所示。
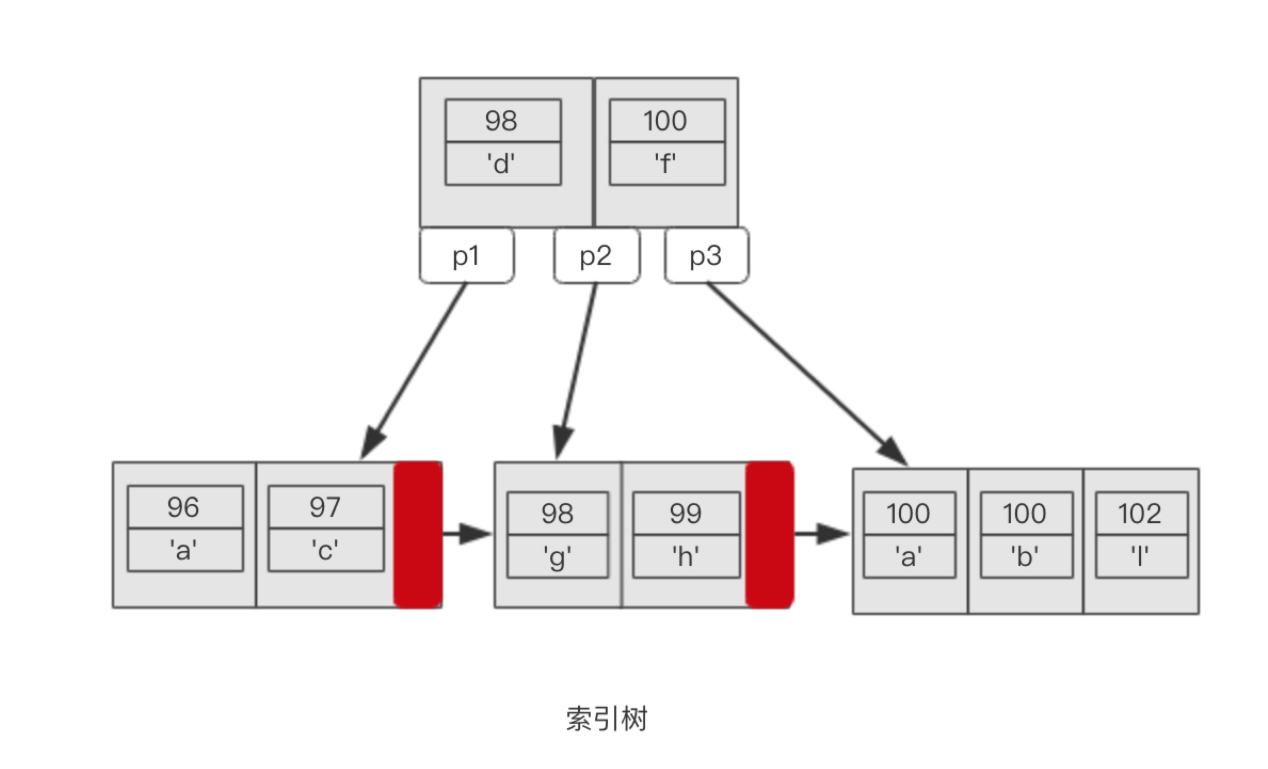
特点跟单列索引一样,不同之处在于他的排序,如果第一个字段相同时会按第二个索引字段排序
如何通过B-tree快速查找数据?
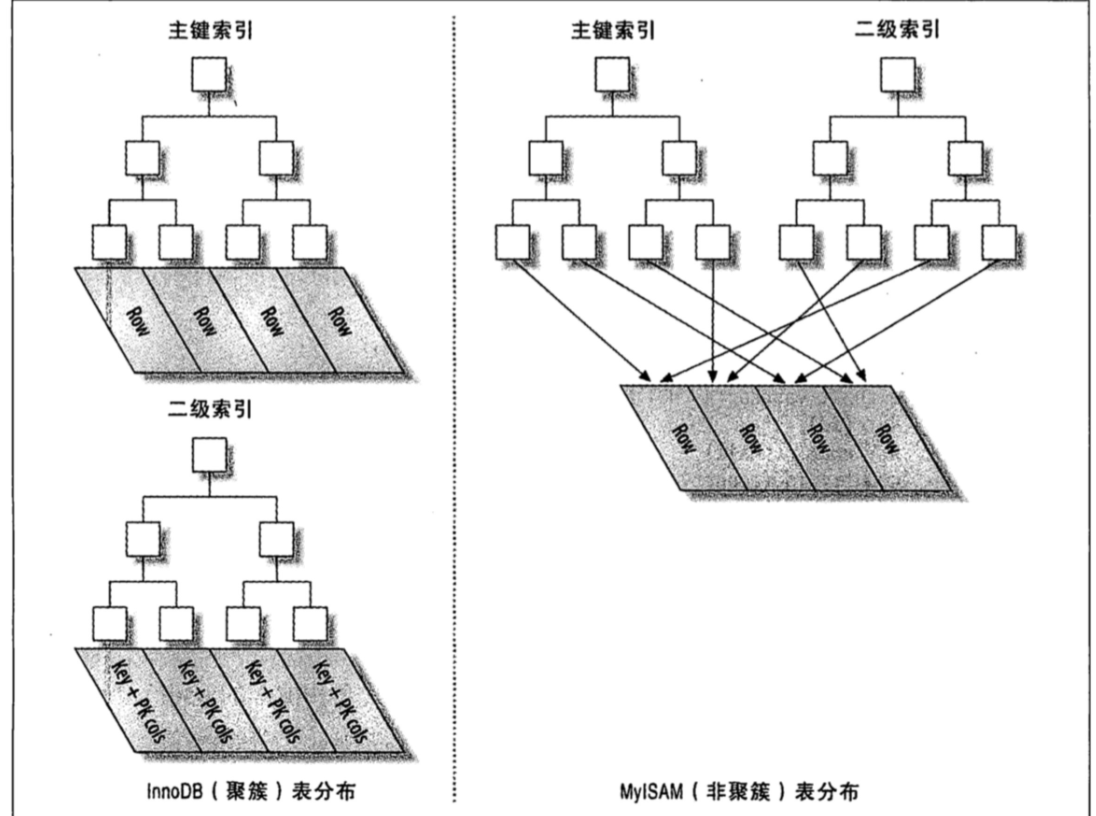
对于InnoDb 存储引擎的B-tree索引,会按一下步骤通过索引找到行数据
如果使用了聚簇索引(主键),则叶子节点上就包含行数据,可直接返回
如果使用了非聚簇索引(普通索引),则在叶子节点存了主键,再根据主键查询一次上面
的聚簇索引
原创不易,完成人机校验,阅读全文