90%的Java程序员,都扛不住这波消息中间件的面试四连炮!
概述
大家平时也有用到一些消息中间件(MQ),但是对其理解可能仅停留在会使用API能实现生产消息、消费消息就完事了。
对MQ更加深入的问题,可能很多人没怎么思考过。
比如,你跳槽面试时,如果面试官看到你简历上写了,熟练掌握消息中间件,那么很可能给你发起如下 4 个面试连环炮!
为什么要使用MQ?
使用了MQ之后有什么优缺点?
怎么保证MQ消息不丢失?
怎么保证MQ的高可用性?
本文将通过一些场景,配合着通俗易懂的语言和多张手绘彩图,讨论一下这些问题。
为什么要使用MQ?
相信大家也听过这样的一句话:好的架构不是设计出来的,是演进出来的。
这句话在引入MQ的场景同样适用,使用MQ必定有其道理,是用来解决实际问题的。而不是看见别人用了,我也用着玩儿一下。
其实使用MQ的场景有挺多的,但是比较核心的有3个:
异步、解耦、削峰填谷
异步
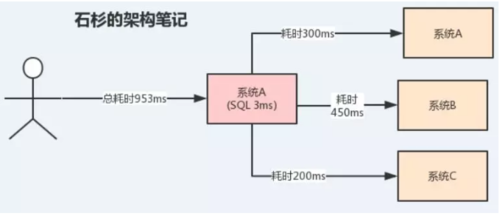
我们通过实际案例说明:假设A系统接收一个请求,需要在自己本地写库执行SQL,然后需要调用BCD三个系统的接口。
假设自己本地写库要3ms,调用BCD三个系统分别要300ms、450ms、200ms。
那么最终请求总延时是3 + 300 + 450 + 200 = 953ms,接近1s,可能用户会感觉太慢了。
此时整个系统大概是这样的:
但是一旦使用了MQ之后,系统A只需要发送3条消息到MQ中的3个消息队列,然后就返回给用户了。
假设发送消息到MQ中耗时20ms,那么用户感知到这个接口的耗时仅仅是20 + 3 = 23ms,用户几乎无感知,倍儿爽!
此时整个系统结构大概是这样的:
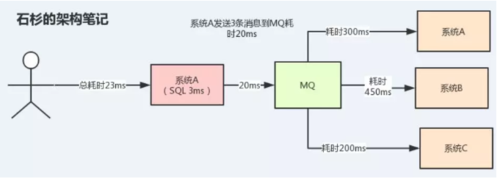
可以看到,通过MQ的异步功能,可以大大提高接口的性能。
解耦
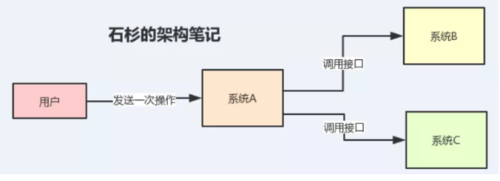
假设A系统在用户发生某个操作的时候,需要把用户提交的数据同时推送到B、C两个系统的时候。
这个时候负责A系统的哥们想:没事啊,B、C两个系统给我提供一个Http接口或者RPC接口,我把数据推送过去不就完事了吗。负责A系统的哥们美滋滋。
如下图所示:
一切看起来很美好,但是随着业务快速迭代,这个时候系统D也想要这个数据。那既然这样,A系统的开发同学就改咯,在发送数据给BC的同时加上一个D。
但是,越到后面越发现,麻烦来了。。。
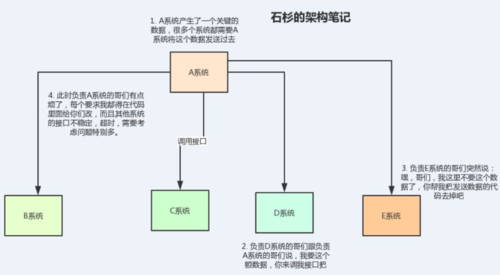
整个系统好像不止这个数据要发送给BCD、还有第二、第三个数据要发送给BCD。甚至有时候又加入了E、F等等系统,他们也要这个数据。
并且有时候可能B系统突然又不要这个数据了,A系统该来改去,A系统的开发哥们头皮发麻。
更复杂的场景是,数据通过接口传给其他系统有时候还要考虑重试、超时等一些异常情况,真是头发都白了呀。。。
来看下图,体会一下这无助的现场:
这个时候,就该我们的MQ粉墨登场了!
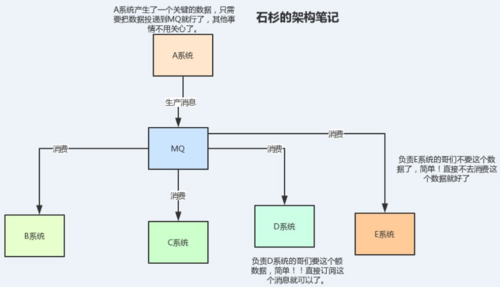
这种情况下使用MQ来解耦是在合适不过了,因为负责A系统的哥们只需要把消息扔到MQ就行了,其他系统按需来订阅消息就好了。
就算某个系统不需要这个数据了,也不会需要A系统改动代码。
看看加入MQ解耦的下图,是不是清爽了很多!
削峰填谷
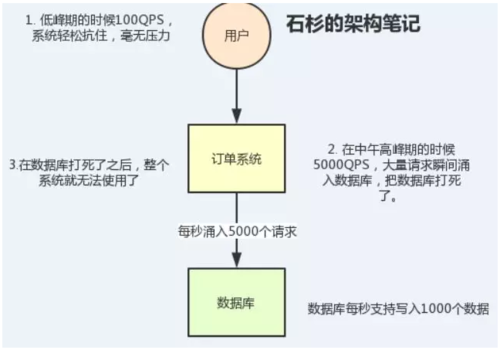
举个例子,比如我们的订单系统,在下单的时候就会往数据库写数据。但是数据库只能支撑每秒1000左右的并发写入,并发量再高就容易宕机。
低峰期的时候并发也就100多个,但是在高峰期时候,并发量会突然激增到5000以上,这个时候数据库肯定死了。
如下图,来感受一下数据库被打死的绝望:
但是使用了MQ之后,情况就变了!
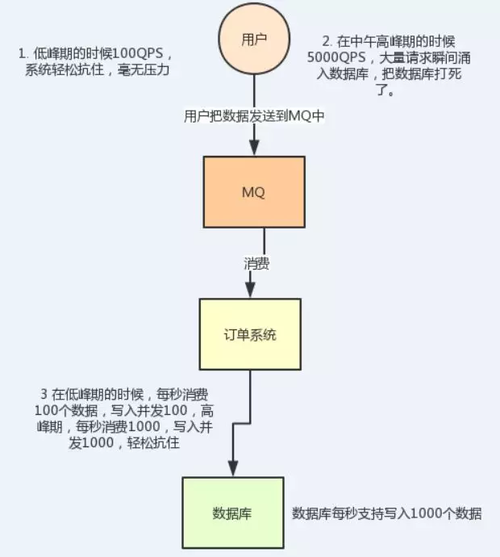
消息被MQ保存起来了,然后系统就可以按照自己的消费能力来消费,比如每秒1000个数据,这样慢慢写入数据库,这样就不会打死数据库了:
整个过程,如下图所示:
至于为什么叫做削峰填谷呢?来看看这个图:
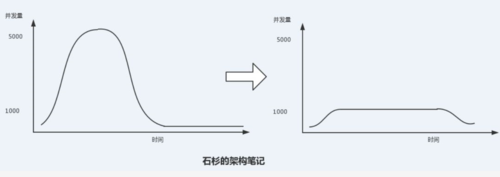
如果没有用MQ的情况下,并发量高峰期的时候是有一个“顶峰”的,然后高峰期过后又是一个低并发的“谷”。
但是使用了MQ之后,限制消费消息的速度为1000,但是这样一来,高峰期产生的数据势必会被积压在MQ中,高峰就被“削”掉了。
但是因为消息积压,在高峰期过后的一段时间内,消费消息的速度还是会维持在1000QPS,直到消费完积压
原创不易,完成人机校验,阅读全文