POI生成word文档完整案例及讲解
一,网上的API讲解
其实POI的生成Word文档的规则就是先把获取到的数据转成xml格式的数据,然后通过xpath解析表单式的应用取值,判断等等,然后在把取到的值放到word文档中,最后在输出来。
1.1,参考一
1、poi之word文档结构介绍之正文段落
一个文档包含多个段落,一个段落包含多个Runs,一个Runs包含多个Run,Run是文档的最小单元
获取所有段落:List<XWPFParagraph> paragraphs = word.getParagraphs();
获取一个段落中的所有Runs:List<XWPFRun> xwpfRuns = xwpfParagraph.getRuns();
获取一个Runs中的一个Run:XWPFRun run = xwpfRuns.get(index);
2、poi之word文档结构介绍之正文表格
一个文档包含多个表格,一个表格包含多行,一行包含多列(格),每一格的内容相当于一个完整的文档
获取所有表格:List<XWPFTable> xwpfTables = doc.getTables();
获取一个表格中的所有行:List<XWPFTableRow> xwpfTableRows = xwpfTable.getRows();
获取一行中的所有列:List<XWPFTableCell> xwpfTableCells = xwpfTableRow.getTableCells();
获取一格里的内容:List<XWPFParagraph> paragraphs = xwpfTableCell.getParagraphs();
之后和正文段落一样
注:
表格的一格相当于一个完整的docx文档,只是没有页眉和页脚。里面可以有表格,使用xwpfTableCell.getTables()获取,and so on
在poi文档中段落和表格是完全分开的,如果在两个段落中有一个表格,在poi中是没办法确定表格在段落中间的。(当然除非你本来知道了,这句是废话)。只有文档的格式固定,才能正确的得到文档的结构
3、poi之word文档结构介绍之页眉:
一个文档可以有多个页眉(不知道怎么会有多个页眉。。。),页眉里面可以包含段落和表格
获取文档的页眉:List<XWPFHeader> headerList = doc.getHeaderList();
获取页眉里的所有段落:List<XWPFParagraph> paras = header.getParagraphs();
获取页眉里的所有表格:List<XWPFTable> tables = header.getTables();
之后就一样了
4、poi之word文档结构介绍之页脚:
页脚和页眉基本类似,可以获取表示页数的角标
1.2,参考二
POI操作Word简介
POI读写Excel功能强大、操作简单。但是POI操作时,一般只用它读取word文档,POI只能能够创建简单的word文档,相对而言POI操作时的功能太少。
(2)POI创建Word文档的简单示例
XWPFDocument doc = new XWPFDocument();// 创建Word文件XWPFParagraph p = doc.createParagraph();// 新建一个段落p.setAlignment(ParagraphAlignment.CENTER);// 设置段落的对齐方式p.setBorderBottom(Borders.DOUBLE);//设置下边框p.setBorderTop(Borders.DOUBLE);//设置上边框p.setBorderRight(Borders.DOUBLE);//设置右边框p.setBorderLeft(Borders.DOUBLE);//设置左边框XWPFRun r = p.createRun();//创建段落文本r.setText("POI创建的Word段落文本");r.setBold(true);//设置为粗体r.setColor("FF0000");//设置颜色p = doc.createParagraph();// 新建一个段落r = p.createRun();r.setText("POI读写Excel功能强大、操作简单。");XWPFTable table= doc.createTable(3, 3);//创建一个表格table.getRow(0).getCell(0).setText("表格1");table.getRow(1).getCell(1).setText("表格2");table.getRow(2).getCell(2).setText("表格3");FileOutputStream out = newFileOutputStream("d:\\POI\\sample.doc");doc.write(out);out.close();

(3)POI读取Word文档里的文字
FileInputStream stream = newFileInputStream("d:\\POI\\sample.doc");XWPFDocument doc = new XWPFDocument(stream);// 创建Word文件for(XWPFParagraph p : doc.getParagraphs())//遍历段落{System.out.print(p.getParagraphText());}for(XWPFTable table : doc.getTables())//遍历表格{for(XWPFTableRow row : table.getRows()){for(XWPFTableCell cell : row.getTableCells()){System.out.print(cell.getText());}}
1.3,参考三,分段混乱
题:在操作POI替换world时发现getRuns将我们预设的${product}自动切换成了
 ${product, }]${product  }
成了两个部分
解决方法一。(未尝试)
强制把List中的内容合并成一个字符串,替换内容后,把段落中的XWPFRun全部remove掉,然后新建一个含有替换后内容的XPWFRun,并赋给当前段落。
解决方法二.
请用复制粘贴把你的${product}添加进world文档里面即可解决,不要手打 目前发现复制粘贴是没有问题的,感觉像是poi的一个bug不知道立贴为证。
注意:${这里尽量不要存中文,否在还出现上面情况}
二,项目应用
2.1,判断生成word的条件
private boolean getXpathRes(String json,String xpathRule){
        boolean isTrue = false;
        try {
            JSONObject obj = getGoodJson(json, json.replaceAll("\n", "").replaceAll("\"null\"", "\"\"").replaceAll(":null,", ":\"\",").replaceAll(" \"", "\""));
            XMLSerializer serializer = new XMLSerializer();
            String xml = serializer.write(obj,"UTF-8");
            log.info("测试用的,记得删除"+xml);
            DocumentBuilderFactory dbf = DocumentBuilderFactory.newInstance();
            dbf.setValidating(false);
            DocumentBuilder db;
            db = dbf.newDocumentBuilder();
            StringReader stringReader = new StringReader(xml);
            InputSource inputSource = new InputSource(stringReader);
            Document doc;
            doc = db.parse(inputSource);
            XPathFactory factory = XPathFactory.newInstance();
            XPath  xpath = factory.newXPath();
            isTrue = (Boolean) xpath.evaluate(xpathRule, doc,XPathConstants.BOOLEAN);
        } catch (Exception e) {
            log.info("合同解析生成XML报错:"+e.getMessage());
        }finally{
            return isTrue;
        }
//        return true;
    }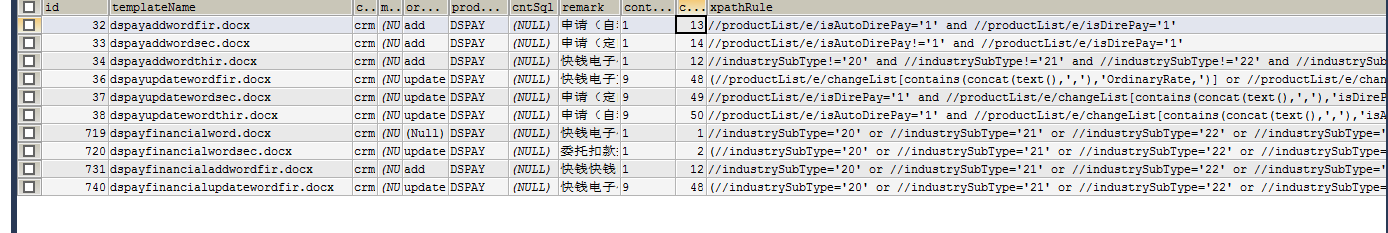
2.1.1,下面就是根据从数据库中取到值,判断规则,和json数据做对比的,就是json数据中有没有数据库中要的值。判断规则是xpath的规则运算符。
JSONObject obj = getGoodJson(json, json.replaceAll("\n", "").replaceAll("\"null\"", "\"\"").replaceAll(":null,", ":\"\",").replaceAll(" \"", "\""));
XMLSerializer serializer = new XMLSerializer();
String xml = serializer.write(obj,"UTF-8");
--把json格式的数据以xml的格式输出
首先得到:得到 DOM 解析器的工厂实例
DocumentBuilderFactory dbf = DocumentBuilderFactory.newInstance();
然后从 DOM 工厂获得 DOM 解析器
dbf.setValidating(false);默认是false
DocumentBuilder db;
db = dbf.newDocumentBuilder();
当你有一组应用程序接口(API)只允许用Writer或Reader作为输入,但你又想使用String,这时可以用StringWriter或StringReader。
当读入文件时也一样。可以用StringReader代替Reader来哄骗API,而不必非得从某种形式的文件中读入。StringReader的构造器要求一个String参数。例如:xmlReader.parse(new InputSource(new StringReader(xmlStr)));
StringReader stringReader = new StringReader(xml);
--- 把符合xml的String转成document对象被java程序解读
StringReader stringReader = new StringReader(xml);
InputSource inputSource = new InputSource(stringReader);
Document doc;
doc = db.parse(inputSource);
--用xpath解析
--生成xpath对象
XPathFactory factory = XPathFactory.newInstance();
XPath xpath = factory.newXPath();
在 Java 中计算 XPath 表达式时,第二个参数指定需要的返回类型。有五种可能,都在javax.xml.xpath.XPathConstants 类中命名了常量:
XPathConstants.NODESET
XPathConstants.BOOLEAN
XPathConstants.NUMBER
XPathConstants.STRING
XPathConstants.NODE 获取节点 node.getTextContent() 获得节点的内容
xpathRule:数据库中存储的
//industrySubType!='20' and //industrySubType!='21' and //industrySubType!='22' and //industrySubType!='23' and //industrySubType!='26' and //industrySubType!='27' and //industrySubType!='28' and //industrySubType!='29' and //industrySubType!='30' and //industrySubType!='148' and //industrySubType!='31' and //industrySubType!='32' and //industrySubType!='37' and //industrySubType!='38' and //industrySubType!='39' and //industrySubType!='11' and //industrySubType!='12' and //industrySubType!='13' and //industrySubType!='14' and //industrySubType!='15' and //industrySubType!='16'
//标示节点中的所有的xml节点
doc就是经过一系列处理,把json数据转化成document对象,并且能被xpath解读的对象:
XPathConstants.BOOLEAN:是返回值,有这个数据就返回true,没有就是false
isTrue = (Boolean) xpath.evaluate(xpathRule, doc,XPathConstants.BOOLEAN);
这里需要见xpath的解析规则
2.2,获取模板之后,开始获取里面的参数,这个参数是在数据库中配置的。
private List<Map<String,Object>> getTemplateParam(List<String> templatNameList,
        String workOrderId, String productCode,String contractNum,long merchantCode,boolean isMainFlag) throws Exception
    {
        log.info("======获取模板原始参数开始===获得的模板有templatNameList=="+templatNameList.toString()+"======");
        List<EcontractTemplateParamsqlAdvanced> aTemplateParamSqlList = new ArrayList<EcontractTemplateParamsqlAdvanced>();
        List<Map<String,Object>> aTemplateParamList = new ArrayList<Map<String,Object>>();

        List<EcontractTemplateParamAdvanced> orginParamList = new ArrayList<EcontractTemplateParamAdvanced>();

        Map<String, Object> rsMap = null;
        Map<String,Object> queryTemplateParamSql = new HashMap<String,Object>();
        Map<String,Object> queryOriginParam = new HashMap<String,Object>();

        //获取每个模板的参数
        for(String templateName : templatNameList)
        {
            log.info("======获取模板原始参数中===获得的模板有templatNameList=="+templatNameList.toString()+"==成功获取到模板文档====");
            queryOriginParam.put("templateName", templateName.split(",")[0]);
            //aTemplateParamSqlList = econtractTemplateParamsqlAdvancedService.queryEcontractTemplateParamsqlAdvancedByMap(queryTemplateParamSql);
            //获取每个模板需要替换的参数
            orginParamList = econtractTemplateParamAdvancedService.queryEcontractTemplateParamAdvancedByMap(queryOriginParam);

            Map<String,String> searchMap = new HashMap<String,String>();
            searchMap.put("orderId", templateName.split(",")[1]);
            WorkorderDetail workOrderDeatil = workorderDetailService.findWorkorderDetailByMap(searchMap);
            String json = workOrderDeatil.getProductParam();
            String jsonStr = json.replaceAll("\n", "").replaceAll("\"null\"", "\"\"").replaceAll(":null,", ":\"\",").replaceAll(" \"", "\"");
            rsMap =  new HashMap<String,Object>();
            Map<String, Object> res = getGoodJsonMap(json, jsonStr);
            String xpath="";
            for(EcontractTemplateParamAdvanced paramAdvancde:orginParamList){
                xpath = paramAdvancde.getMethodParam();
                if(res.get(paramAdvancde.getFieldName())==null){
                    /
原创不易,完成人机校验,阅读全文