ID 明明存在,为什么 404?你的雪花 ID 正被浏览器静默改写
—— Long 序列化三种治理方案的演进与取舍
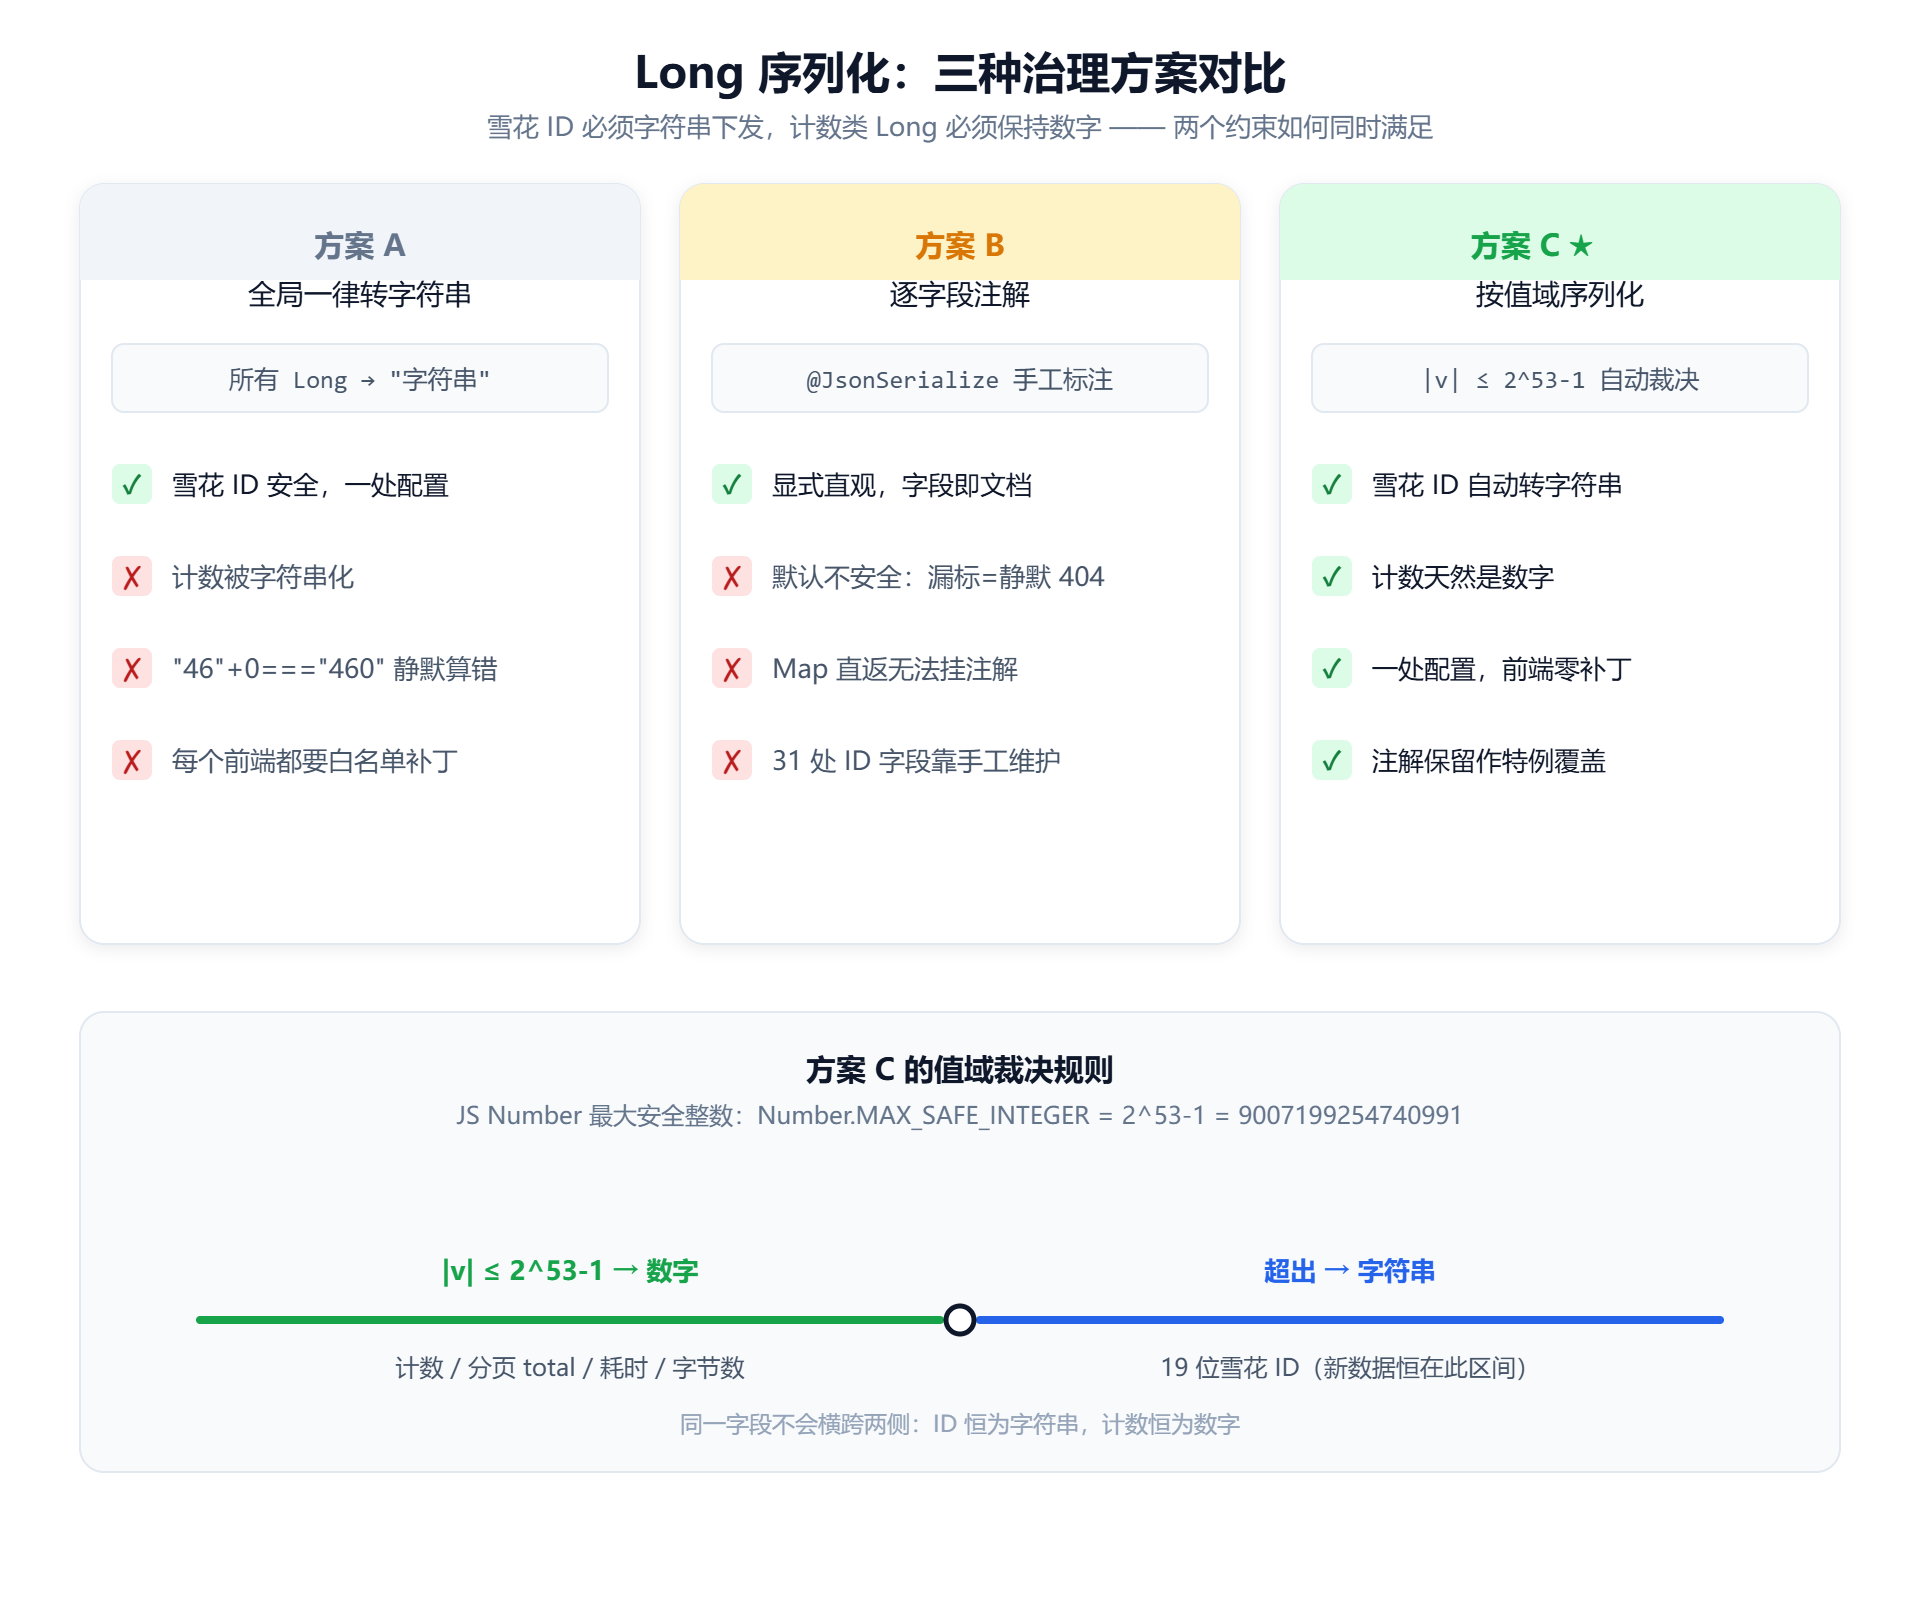
背景:一个 Java 21 + Spring Boot 4(Jackson 3)+ MyBatis-Plus 雪花主键的前后端分离项目, 客户端形态包括 PC 管理端、门户 Web、小程序/UniApp 移动端。本文记录该问题在一个真实 项目里的三次方案演进:全局一律转字符串 → 逐字段注解(被否)→ 全局按值域序列化(最终), 并给出决策依据与回归测试设计。代码示例均可直接复用。
TL;DR
- 超过 2^53-1 的整数经
JSON.parse会被静默改写末几位,雪花 ID 必须以字符串形式下发; - "所有 Long 一律转字符串"修复了 ID,却把计数/分页/耗时拖下水——前端被迫维护字段名 白名单逐个还原,漏一个就是静默算错;
- 逐字段注解(
@JsonSerialize)显式性好,但它是"默认不安全、靠自觉",且 Map 直返等 场景根本挂不上注解; - 最终解:全局按值域序列化——|v| ≤ 2^53-1 输出数字,超出输出字符串。一处配置, ID 与计数同时正确,前端不再需要任何补丁;
- 注解不必扔掉:Jackson 注解优先级高于全局模块注册,留作特例覆盖手段。
一、问题:19 位 ID 被浏览器悄悄改写
MyBatis-Plus 雪花算法生成的主键是 19 位 Long(形如 2099404618435072002),而 ECMAScript
的 Number 只能精确表示到 2^53-1(9007199254740991,16 位)。后端若把 ID 按 JSON 数字
下发,浏览器 JSON.parse 时会不报错地改写末几位:
JSON.parse('{"id": 2099404618435072002}')
// { id: 2099404618435072000 }   ← 末尾 002 变 000,无任何异常
前端再拿这个 ID 去调编辑/删除接口,必然 404。更阴险的是暴露条件:存量数据的主键往往是
自增小数字(344、1530),一切正常;缺陷只在新插入的记录上出现。这类"测试环境
数据旧所以测不出来"的问题,通常要等 E2E 全链路自测才会现形——本项目正是如此。
二、为什么前端补丁治不了根
受影响的是所有消费 JSON 的客户端:PC 管理端、门户 Web、小程序、App、未来的第三方
脚本。在每个客户端里各写一层"ID 字段转字符串"的拦截器毫无意义——消息在
JSON.parse 那一刻已经丢精度了,事后再 toString 补救的字符串是错的。
所以修只能修在后端序列化这一处。问题只剩下:怎么修。
三、方案 A:全局一律转字符串(第一版)
最常见的做法,注册全局序列化器把 Long 一律输出为字符串:
SimpleModule module = new SimpleModule();
module.addSerializer(Long.class, ToStringSerializer.instance);
module.addSerializer(Long.TYPE, ToStringSerializer.instance);
ID 问题彻底解决,且是默认安全:新增任何 VO/字段都不需要记得任何事。
但副作用很快出现——计数、分页 total、文件字节数、耗时这些小值 Long也成了字符串。 前端一旦做算术就是字符串拼接,而且极具迷惑性:
"46" + 0    === "460"    // 静默算错
"46" - 0    === 46       // 恰好对,所以很难发现
"150" >= 46 === false    // 按字典序比较
我们的管理端为此维护了一个"字段名白名单"还
原创不易,完成人机校验,阅读全文