YOLO或者其他模型怎么集成到dify中?
YOLO或者其他模型怎么集成到dify中?这是一个非常棒和具体的应用场景!您这个“施工安全智能监测”的想法非常适合用YOLO和SAM的组合来实现。这是一个经典的目标检测+实例分割 pipeline,技术上非常成熟可行。我来为您梳理一个清晰的实现方案和技术选型建议。整体技术思路您的需求可以拆解为两个主要阶段,其工作流程可以参考下图:下面我们详细拆解每个阶段。阶段一:YOLO目标检测(发现问
YOLO或者其他模型怎么集成到dify中?这是一个非常棒和具体的应用场景!您这个“施工安全智能监测”的想法非常适合用YOLO和SAM的组合来实现。这是一个经典的目标检测+实例分割 pipeline,技术上非常成熟可行。
我来为您梳理一个清晰的实现方案和技术选型建议。
整体技术思路
您的需求可以拆解为两个主要阶段,其工作流程可以参考下图:
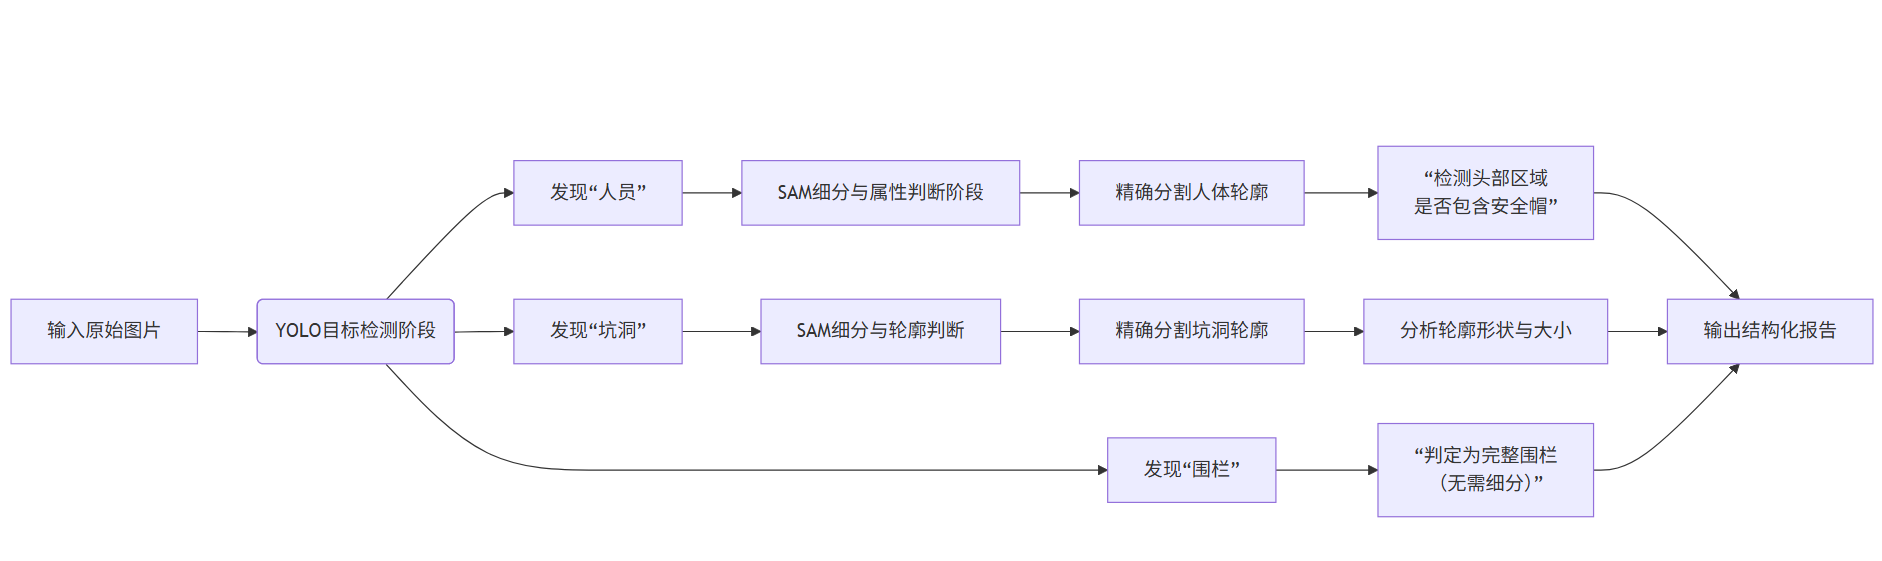
下面我们详细拆解每个阶段。
阶段一:YOLO 目标检测(发现问题目标)
这是第一步,用YOLO模型在图片中快速定位出您关心的几类目标:
人员(Person)
安全帽(Helmet)/(也可以直接检测“人员”是否戴安全帽)
坑洞(Pit)
围栏/警戒线(Fence/Barrier)
技术选型建议:
YOLOv8:Ultralytics 公司维护,API 非常友好,训练简单,生态成熟。是当前最推荐入门和部署的版本。
YOLOv9:最新版本,在精度和效率上有进一步提升。但新出炉可能社区和资源相对少一些。
YOLOv5:虽然较旧,但极其稳定,资料丰富,完全够用。
您的任务: 您需要收集大量施工现场的图片,并标注上述几类目标框,然后用自己的数据对预训练的YOLO模型进行微调,这样它才能特别擅长识别您关心的这些场景。
阶段二:SAM 图像分割(精细分析目标)
在YOLO定位到目标后,使用SAM对特定目标进行像素级的精细分割:
对于“人员”:将YOLO检测到的“人员”框作为提示输入给SAM,SAM会输出该人员的精确像素掩膜。基于这个精确的人体轮廓,可以进一步分析头部区域,从而更准确地判断是否佩戴安全帽。
对于“坑洞”:同样将YOLO检测到的“坑洞”框提示给SAM,得到坑洞的
原创不易,完成人机校验,阅读全文