深入剖析 Java 循环方式:for - i、for - each 与 Iterable.forEach
深入剖析 Java 循环方式:for - i、for - each 与 Iterable.forEach
本文标签:Java循环方式、for-i循环、for-each循环、JVM底层机制
摘要
本文从字节码、JVM 底层机制和性能角度,深入剖析 for - i、for - each 和 Iterable.forEach 三种循环方式的区别。详细阐述它们在不同数据结构和大数据量场景下的表现,给出对比表格和处理建议,并重点探讨了如何在实际项目中根据数据结构、性能要求和并行处理需求选择合适的循环方式。
在 Java 编程中,循环是处理数据集合的常用手段。而 for - i、for - each(增强 for 循环)和 Iterable.forEach 这三种循环方式,在不同的场景下有着不同的表现。接下来,我们将从字节码、JVM 底层机制和性能角度,深入剖析它们之间的区别,尤其是在大数据量场景下的表现,并探讨如何在实际项目中选择合适的循环方式。
传统的 for - i 循环:索引循环的奥秘for - i 循环是最原始、最基础的循环方式。它直接操作索引,循环变量是一个简单的 int 类型索引,不依赖于任何迭代器或函数式接口。
字节码层面探秘
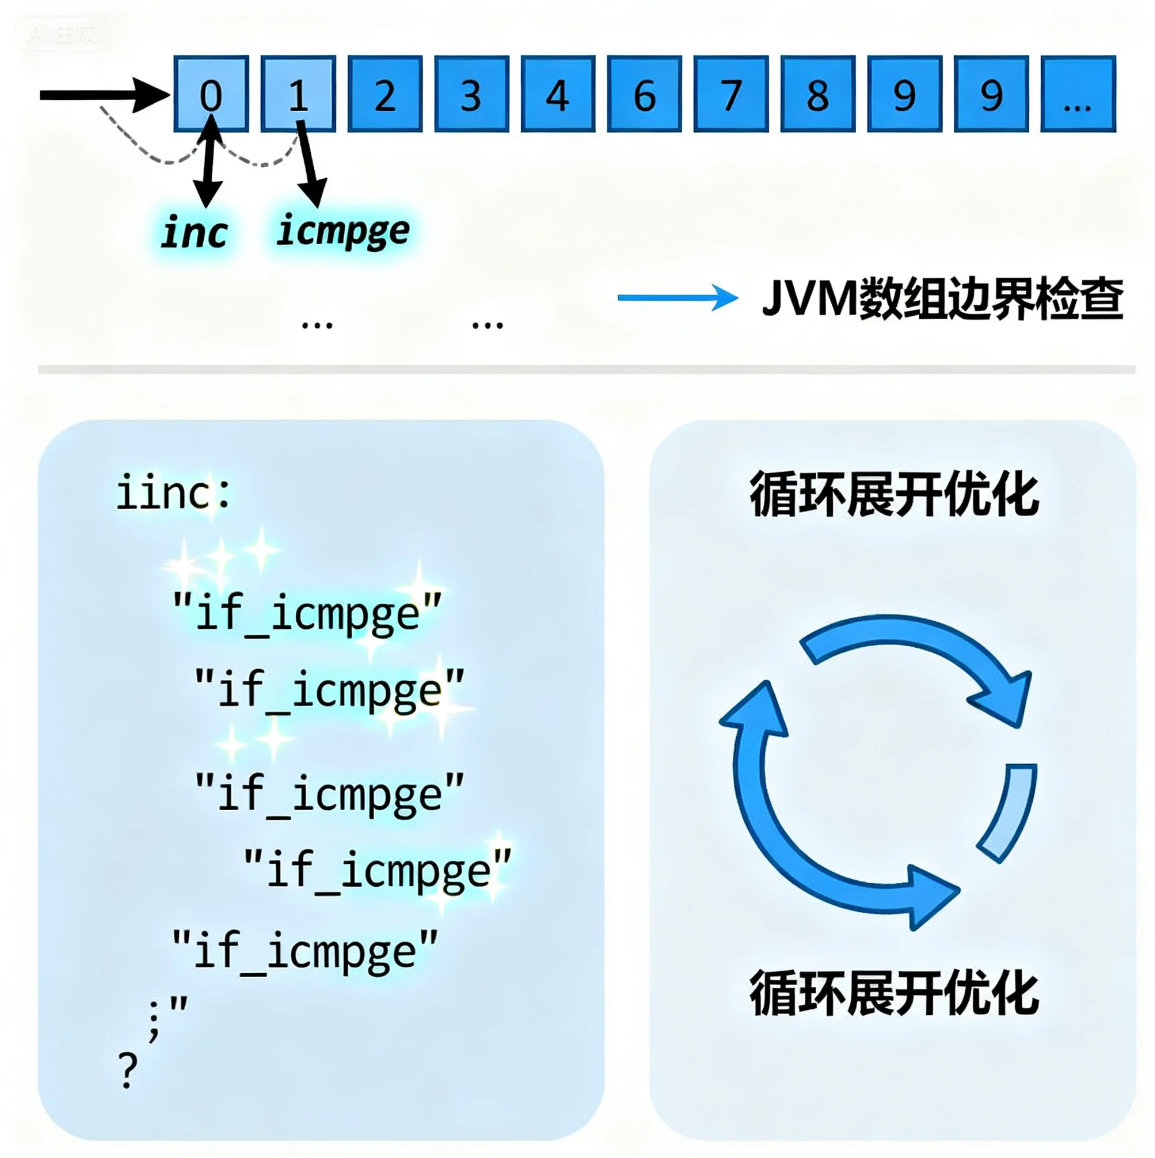
编译后的字节码非常简洁,主要包含几个关键指令。iinc 指令用于增加索引,就像 i++ 操作;iload 和 istore 指令用于加载和存储索引及比较的值;if_icmpge(或类似的条件跳转指令)用于比较索引和数组长度或集合大小,以此决定是否跳出循环。
不同数据结构的访问效率
对于数组,JVM 经过边界检查后,能通过内存偏移量(如 aload、iaload 等指令)直接访问元素,效率极高。现代 JVM 的 JIT 编译器还会对边界检查进行优化,比如循环展开、将检查移出循环等。对于像 ArrayList 这样基于数组实现的集合,list.get(i) 本质上也是数组访问,性能接近直接访问数组。然而,对于 LinkedList,get(i) 每次调用都需要从链表头或尾开始遍历,是一个 O(n) 操作。在循环中使用时,总体时间复杂度会变为 O(n²),这对性能的影响是灾难性的。
大数据量下的性能表现
在处理数组或 ArrayList 时,for - i 循环性能最优。它的开销极小,只有索引的递增和条件判断,JVM 可以对其进行大量优化,是处理海量数据的首选。但如果是 LinkedList,绝对禁止使用 for - i 循环。
增强的 for - each 循环:语法糖背后的秘密for - each 循环是一种语法糖,编译后会被解糖为传统的 Iterator 循环方式。
底层实现机制
编译器会自动生成基于 Iterator 的代码。例如,对于一个 List<String> 集合,源代码中的 for - each 循环会被编译器转换为使用 Iterator 的循环。它隐式地使用了集合的 iterator() 方法返回的 Iterator 对象,每次循环调用 hasNext() 和 next() 方法。
不同数据结构的性能表现
对于 ArrayList,其 Iterator 实现(Itr 类)内部维护了一个 int cursor 索引,next() 方法本质上和 get(i) 一样,是高效的数组访问。对于 LinkedList,其 Iterator 实现(ListItr 类)内部维护了一个 Node<E> 引用,next() 方法只是移动指针并返回内容,是 O(1) 操作,这是遍历 LinkedList 的正确且高效的方式。对于数组,编译器会将 for - each 循环生成一个等价的 for - i 循环。
大数据量下的性能与开销
for - each 循环通用性强,
原创不易,完成人机校验,阅读全文