TDengine的数据建模?库、表、超级表是什么?怎么用?
欢迎来到物联网的数据世界
在典型的物联网场景中,一般有多种不同类型的采集设备,采集多种不同的物理量,同一种采集设备类型,往往有多个设备分布在不同的地点,系统需对各种采集的数据汇总,进行计算和分析对于同一类设备,其采集的数据都是很规则的。
本文我们以智能电表(采集量为电流、电压)为例,探讨如何在TDengine中建库、建超级表、建表。
假设每个智能电表采集电流、电压两个量,其采集的数据如下图所示。
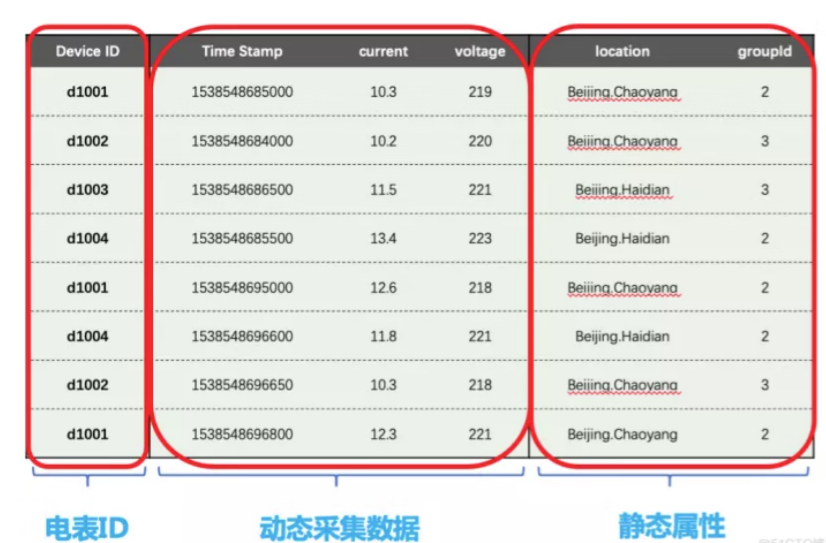
每一条记录都有设备ID,时间戳,采集的物理量(如上图中的电流、电压),还有与每个设备相关的静态标签(如上图中的位置Location和分组groupId)。每个设备是受外界的触发,或按照设定的周期采集数据。采集的数据点是时序的,是一个数据流。
那么TDengine如何抽象这些物联网数据呢?
这里,需要提到TDengine的关键创新点——一个采集点一张表。同一类型的采集点用一个超级表来描述,也就是一个表结构Schema和静态标签Schema 。就上图来说,电表ID作为子表名(d1001, d1002, d1003, d1004等),动态采集的物理量作为各字段,静态属性(Location和groupId)作为子表标签。利用超级表作为模板,生成子表 – 对应各采集点,有了超级表,极大地方便了同类采集点的数据检索、查询、聚合。
这种设计有几大优点:
能保证一个采集点的数据在存储介质上是以块为单位连续存储的。如果读取一个时间段的数据,它能大幅减少随机读取操作,成数量级的提升读取和查询速度。
由于不同采集设备产生数据的过程完全独立,每个设备的数据源是唯一的,一张表也就只有一个写入者,这样就可采用无锁方式来写,写入速度就能大幅提升。
对于一个数据采集点而言,其产生的数据是时序的,因此写的操作可用追加的方式实现,进一步大幅提高数据写入速度。
如果采用传统的方式,将多个设备的数据写入一张表,由于网络延时不可控,不同设备的数据到达服务器的时序是无法保证的,写入操作是要有锁保护的,而且一个设备的数据是难以保证连续存储在一起的。采用一个数据采集点一张表的方式,能最大程度的保证单个数据采集点的插入和查询的性能是最优的。
数据建模的基本方法
TDengine采用关系型数据模型,需要建库、建表。因此对于一个具体的应用场景,需要考虑库的设计,超级表和普通表的设计。
CREATE DATABASE dbname
USE dbname
CREATE TABLE stbname (ts timestamp, other fields…) tags ( tag fields)
CREATE TABLE tbname using stbname tags(具体标签值)
INSERT INTO tbname VALUES(now, values…)
实例
INSERT INTO ${tableName} USING xm_values (groupId) TAGS (2)
        VALUES
        <foreach collection="paramList" item="param"  separator=",">
            (
            #{param.time_new},
原创不易,完成人机校验,阅读全文