docker高级篇2-分布式存储之三种算法
答:单机单台100%是不可能的。肯定是分布式缓存的。那么用Redis如何落地?
插播一条
下面这个公众号是凯哥开发的,福利号:外卖、买菜、电商领Q的
怎么领券?
大家好,我是凯哥Java(kaigejava),乐于分享,每日更新技术文章,欢迎大家关注“凯哥Java”,及时了解更多。让我们一起学Java。也欢迎大家有事没事就来和凯哥聊聊~~~
哈希取余分区:
对redis的key进行hash后和机器总数取余。公式:has(key)%N
这种分区算法的优点:
简单粗暴,直接有效。只需要预估好数据规划好节点。就能保证一段时间的数据支撑。使用HASH算法让固定的一部分请求落到同一台服务器上,这样每台服务器固定处理一部分请求,起到负载均衡+分而治之的作用。
缺点:
原来规划后的节点,进行扩容或者缩容就比较麻烦了。不管是扩容还是缩容,每次数据变更导致几点有变动,映射关系需要重新进行计算。在服务器个数固定不变的时候没问题。如果需要弹性扩容或者故障停机的情况下,原来的取模公式就会发生变化。此时地址经过某个redis机器宕机了。由于机器总数量发生了变化,会导致hash取余全部数据重新洗牌啊!!
一致性哈希算法分区:
一致性hash算法在1997年麻省理工学院提出的,设计目标是为了解决:
分布式缓存数据变动和映射问题。某个机器宕机了,分母数量改变了,自然取余就出问题了。
提出一致性hash解决方案。目的是当服务器个数发生变动的时候,尽量减少影响客户端到服务器的映射关系。
1:算法构建一致性哈希环;
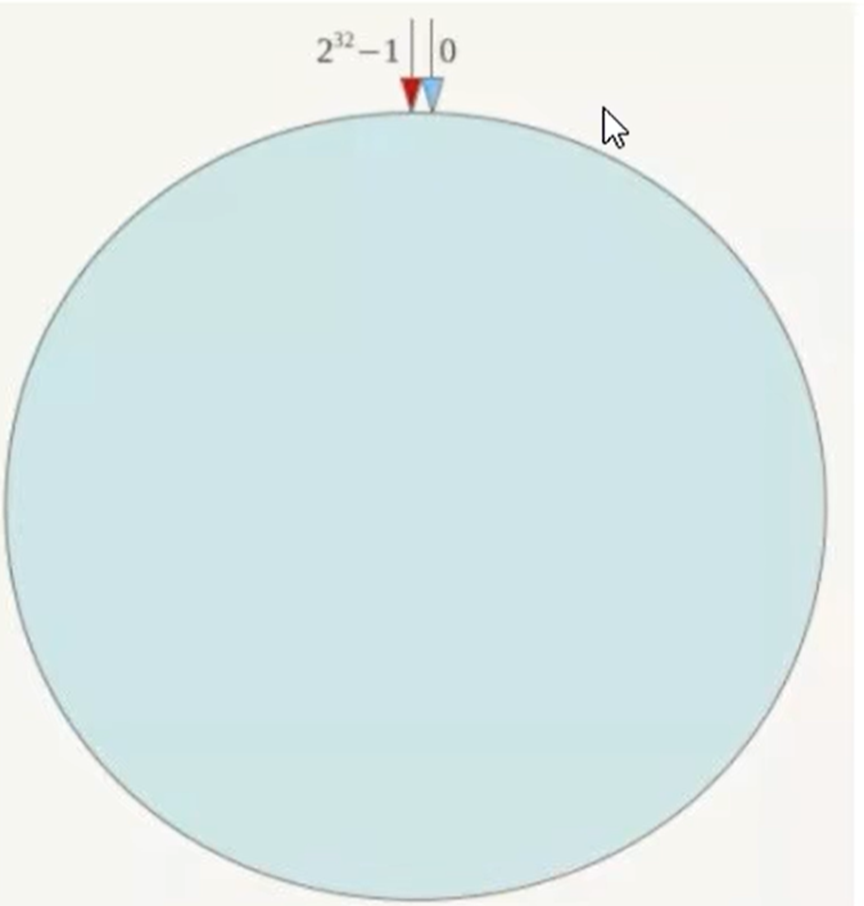
一致性哈希算法必然有个hash函数并安装算法产生hash值,这个算法的所有可能哈希值会构成一个全量集,这个集合可以成为hash空间,范围是[0,2^32-1],这是一个线性空间,但是在算法中,通过适当的逻辑控制将其首尾相连(0=2^32),这样在逻辑上,就形成了一个环形的空间。
一致性哈希环也是使用的取模的方方,是对2^32取模。一致性hash算法将这个哈希值空间组织成一个虚拟的圆环,整个哈希环是按照顺时针方法组织的。如下图:
2:服务器IP节点映射
将集群中的各个IP节点映射到环上的某一个位置。将各个服务器使用hash进行一个hash.(具体可以选择服务器的IP或者主机名称作为关键字进行哈希,这样每台机器就能确定其在哈
原创不易,完成人机校验,阅读全文