【解疑】ConcurrentHashMap 在JDK1.7时候put或get时候,怎么定位到数据的?
在面试的时候,ConcureentHashMap在JDK1.7的时候线程安全底层具体实现方式是什么?
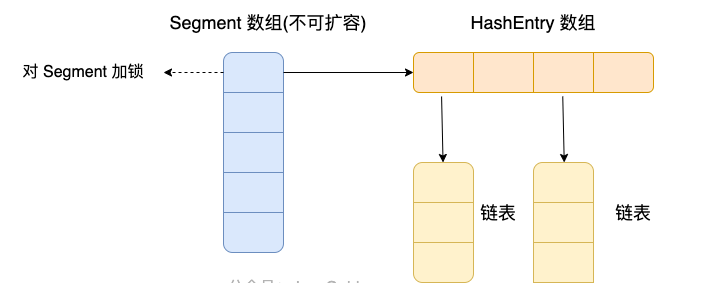
CouncureentHashMap在JDK1.7的时候如下图:
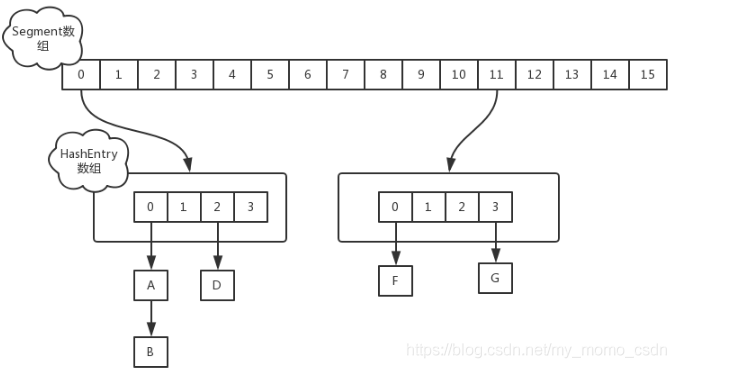
ConcurrentHashMap由Segment数组组成,Segment继承了ReentrantLock可以提供锁的功能,也表示并发度,是最大并行访问的线程数量,每一个Segment内部包含一个HashEntry数组用于元素存储,
HashEntry则是一个K-V的存储单元,尾部可以挂HashEntry使用链地址法解决hash冲突
1.7中的ConcurrentHashMap源码大约1600行,去除大量注释外,我们只需要关注核心方法,
segment大小固定后,就不可变了默认是16个。也就是说,默认支持16个线程并发写。
16个segment就是16把锁(门牌号),那么在put的时候,是怎么定位到那获取哪个门牌号?数据是怎么put进去的?
ConcurrentHashMap定位一个元素需要两次Hahs,,操作,第一次Hash定位到Segement,第二次Hash定位到元素所在的链表的头部.这种结构下,Hash过程比普通的HashMap要久,但是写操作的时候,只对元素所在的Segement加锁即可,不会影响其他的Segement.在理想情况下,ConcurrentHashMap最高可以同时支持Segement数量大小的写操作.正因为这样,ConcurrentHashMap的并发能力得以提高.
我们来看看源码:
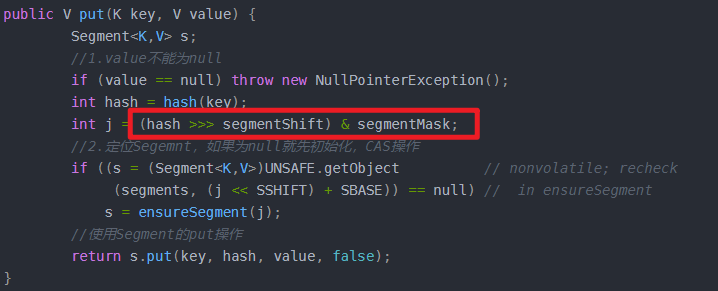
put操作先定位Segment,再定位HashEntry,需要进行2次Hash操作,下面是先定位到Segment
public V put(K key, V value) {
        Segment<K,V> s;
        //1.value不能为null
        if (value == null) throw new NullPointerException();
        int hash = hash(key);
        int j = (hash >>> segmentShift) & segmentMask;
        //2.定位Segemnt,如果为null就先初始化,CAS操作
        if ((s = (Segment<K,V>)UNSAFE.getObject          // nonvolatile; recheck
             (segments, (j << SSHIFT) + SBASE)) == null) //  in ensureSegment
            s = ensureSegment(j);
        //使用Segment的put操作
        return s.put(key, hash, value, false);
}
在得到对应的segment之后,调用s.put方法
Segment 的结构和 HashMap 类似,是一种数组和链表结构,一个 Segment 包含一个 HashEntry 数组,每个 HashEntry 是一个链表结构的元素,每个 Segment 守护着一个 HashEntry 数组里的元素,当对 HashEntry 数组的数据进
原创不易,完成人机校验,阅读全文