项目中常用的19条MySQL优化技巧
一 善用EXPLAIN
做MySQL优化,我们要善用 EXPLAIN 查看SQL执行计划。
下面来个简单的示例,标注(1,2,3,4,5)我们要重点关注的数据
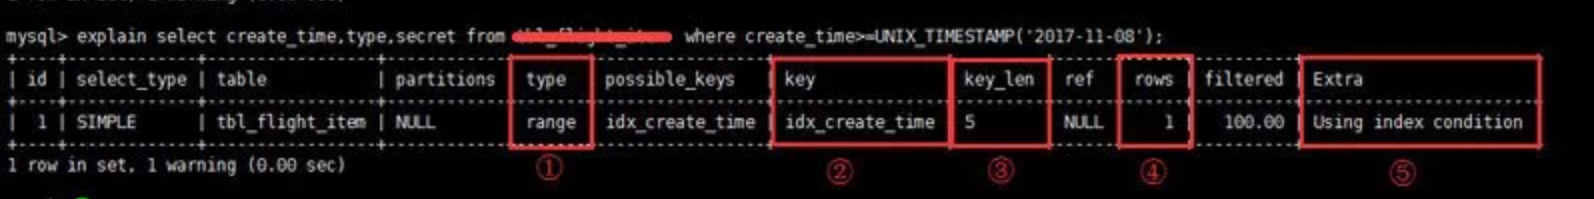
1、type列: 连接类型。一个好的sql语句至少要达到range级别。杜绝出现all级别2、key列: 使用到的索引名。如果没有选择索引,值是NULL。可以采取强制索引方式3、key_len列: 索引长度4、rows列: 扫描行数。该值是个预估值5、Extra列: 详细说明。注意常见的不太友好的值有:Using filesort, Using temporary
二 SQL语句中IN包含的值不应过多
MySQL对于IN做了相应的优化,即将IN中的常量全部存储在一个数组里面,而且这个数组是排好序的。但是如果数值较多,产生的消耗也是比较大的。再例如:select id from table_name where num in(1,2,3) 对于连续的数值,能用 between 就不要用 in 了;再或者使用连接来替换。
三 SELECT语句务必指明字段名称
SELECT * 增加很多不必要的消耗(cpu、io、内存、网络带宽);增加了使用覆盖索引的可能性;当表结构发生改变时,前断也需要更新。所以要求直接在select后面接上字段名。
四 当只需要一条数据的时候,使用limit 1
这是为了使EXPLAIN中type列达到const类型
五 如果排序字段没有用到索引,就尽量少排序
六 如果限制条件中其他字段没有索引,尽量少用or
or两边的字段中,如果有一个不是索引字段,而其他条件也不是索引字段,会造成该查询不走索引的情况。很多时候使用 union all 或者是union(必要的时候)的方式来代替“or”会得到更好的效果
七 尽量用union all代替union
union和union all的差异主要是前者需要将结果集合并后再进行唯一性过滤操作,这就会涉及到排序,增加大量的CPU运算,加大资源消耗及延迟。当然,union all的前提条件是两个结果集没有重复数据。
八 不使用ORDER BY RAND()
select id from `table_name` order by rand() limit 1000;
上面的sql语句,可优化为
select id from `table_name` t1 join (select rand() * (select max(id) from `table_name`) as nid) t2 ont1.id > t2.nid limit 1000;
九 区分in和exists,not in和not exists
select * from 表A where id in (select id from 表B)
上面sql语句相
原创不易,完成人机校验,阅读全文